对话在终端里一切正常,服务一重启,历史就没了。
这类问题最容易被误判成“模型不记事”。但在接入模型之前,我们就能先回答三个更具体的问题:状态有没有写入、写到了哪里、新进程读的是哪条线程?
近期,LangChain 在 2026 年 10 月 14 日的Deep Agents 记忆管理文章中讨论了如何把信息移出活跃上下文。本文把这个技术方向落到一个更基础的排障任务:让真实 LangGraph 图在独立 Python 进程之间保存并读回状态。
这不是 Deep Agents 的完整配置教程,也不测试模型记忆效果;我们只用确定性节点,避免把模型输出的随机性混进持久化实验。
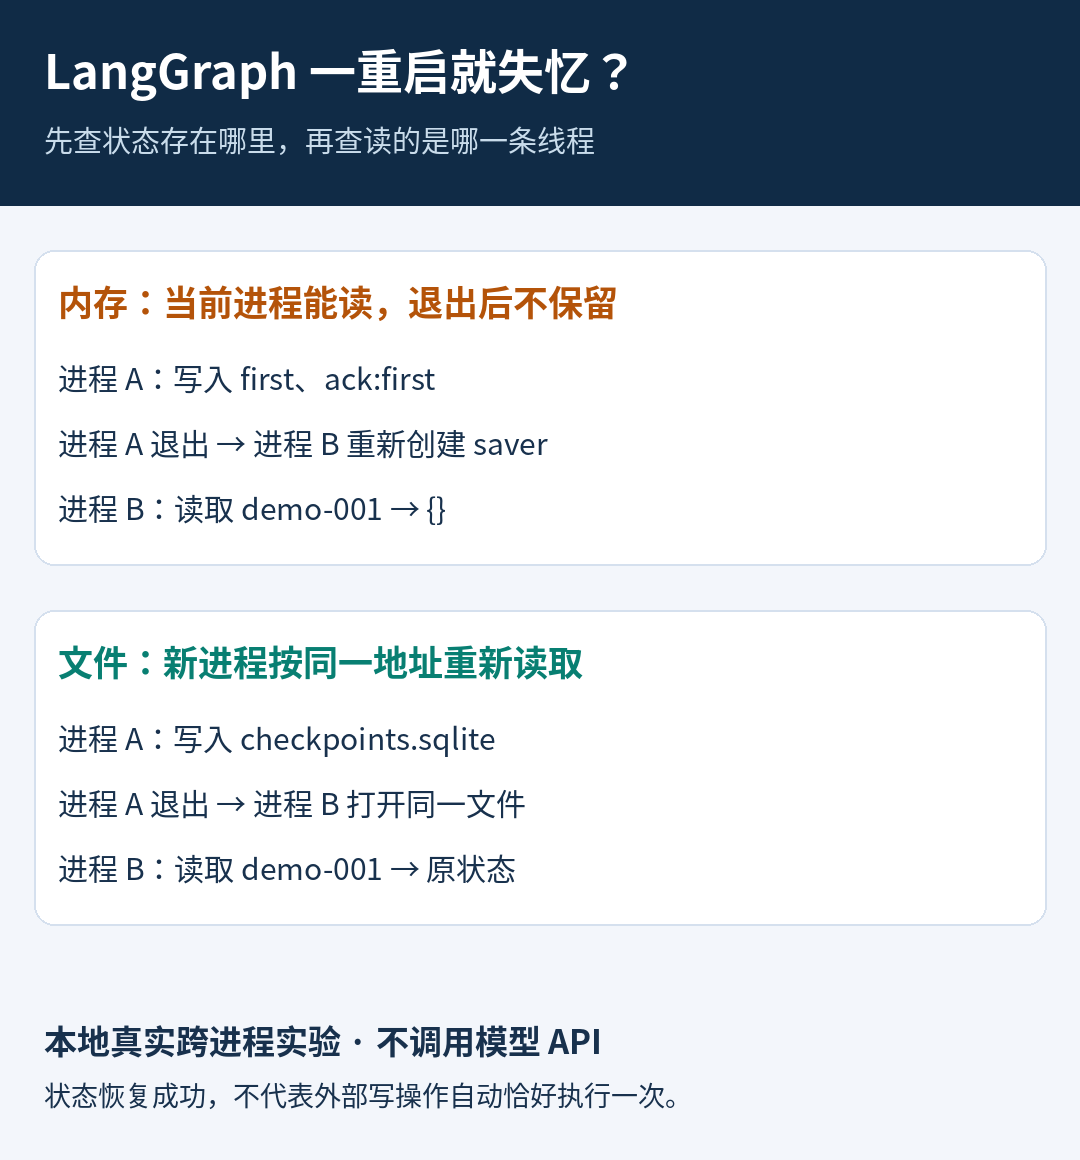
图 1:进程内能读回,不代表进程退出后还能读回。本文会真的退出进程,再启动另一个进程检查。
**适合谁读:**正在排查 LangGraph 重启丢历史、多轮状态没续上、部署后“像新对话”的开发者。
**你会得到:**一份可运行脚本、跨进程对照结果、五类错误条件,以及一张从症状到检查点的排障表。
01|先拆开三个概念:线程、检查点、长期记忆
LangGraph 官方把持久化分成两个互补部分:checkpointer 保存线程内的图状态,store 保存应用定义的跨线程数据。thread_id 用于定位检查点线程,不能直接等同于用户账号。官方持久化说明
在下面的实验里,可以这样理解:
| 概念 | 本例中的作用 | 不应混成什么 |
|---|---|---|
thread_id |
区分 demo-001 与 demo-002 两条线程 |
不是登录凭证,也不是数据库路径 |
| checkpointer | 在图运行时保存、读取状态快照 | 不会自动把进程里所有 Python 对象存下来 |
| SQLite 文件 | 为检查点提供本例的文件存储 | 文件存在,不代表选中的线程一定有状态 |
| store | 本例未使用;适合另外设计跨线程数据 | 不能靠换一个线程 ID 自动得到另一条线程的历史 |
一个直接的设计提醒是:服务端应在验证用户后决定他能访问哪些线程,不要把“前端传来一个 thread_id”当作访问授权。
本文用固定示例 ID 便于复现,真实项目要明确用户、业务会话与图线程的映射。
02|准备环境:不接模型,先把基础行为测清楚
本地实测环境:Python 3.12,核心依赖如下,核验日期为 2026 年 10 月 26 日。
python -m venv .venv
# Linux / macOS:激活后使用下面的 python 与 pip
source .venv/bin/activate
pip install "langgraph==1.2.17" "langgraph-checkpoint-sqlite==3.1.2" "langgraph-checkpoint==4.3.0" "langchain-core==1.7.0"
Windows 可在 PowerShell 使用 .venv\Scripts\Activate.ps1 激活对应环境,再执行安装命令。
建议在一个新建的空实验目录中运行,避免旧检查点使后面的 steps 或历史数量与示例不同。
无需模型 API Key,不调用外部模型,不读写生产数据库。
保存下面代码为 demo.py:
import argparse
import json
import operator
import os
from pathlib import Path
from typing import Annotated, TypedDict

# This demo only uses built-in scalar/list types in checkpoints.
os.environ.setdefault('LANGGRAPH_STRICT_MSGPACK', 'true')

from langgraph.graph import START, END, StateGraph
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.checkpoint.sqlite import SqliteSaver

class State(TypedDict):
    history: Annotated[list[str], operator.add]
    steps: int

def reply(state: State):
    return {'history': ['ack:' + state['history'][-1]],
            'steps': state.get('steps', 0) + 1}

def build(saver):
    builder = StateGraph(State)
    builder.add_node('reply', reply)
    builder.add_edge(START, 'reply')
    builder.add_edge('reply', END)
    return builder.compile(checkpointer=saver)

def execute(graph, args):
    config = {'configurable': {'thread_id': args.thread}}
    if args.inspect:
        values = graph.get_state(config).values
    else:
        values = graph.invoke({'history': [args.text]}, config)
    print(json.dumps(values, ensure_ascii=False, sort_keys=True))

if __name__ == '__main__':
    parser = argparse.ArgumentParser()
    parser.add_argument('--backend', choices=['memory', 'sqlite'], default='sqlite')
    parser.add_argument('--db', default='./data/checkpoints.sqlite')
    parser.add_argument('--thread', default='demo-001')
    parser.add_argument('--text', default='hello')
    parser.add_argument('--inspect', action='store_true')
    args = parser.parse_args()
    if args.backend == 'memory':
        execute(build(InMemorySaver()), args)
    else:
        path = Path(args.db).expanduser().resolve()
        path.parent.mkdir(parents=True, exist_ok=True)
        with SqliteSaver.from_conn_string(str(path)) as saver:
            execute(build(saver), args)
为什么代码这么写?
图只有 START → reply → END,reply 只是给最后一条输入加上 ack:,并让 steps 加一。
这里的 history 使用 operator.add 作为 reducer,因此新输入会追加到已恢复的列表,而不是替换整个列表;这是演示字符串列表的规则,不是聊天消息对象的完整合并协议。
compile(checkpointer=saver) 把保存器接到图上;invoke 与 get_state 传入相同配置,才会面向同一条线程。
--inspect 分支读取图状态,不调用业务节点。需要注意:SQLite 打开不存在的文件路径时会创建新文件,所以这个选项不是“整个文件系统绝不发生写入”的承诺。
文件后端用上下文管理器管理连接生命周期,并将路径转换成绝对路径;但相对路径的起点仍是当前工作目录,不能因为用了 resolve() 就认为不同部署一定指向同一文件。
示例仅使用字符串、列表、整数等内置类型,并按SQLite saver 包说明启用严格消息反序列化设置;真实项目还需要根据状态类型设计序列化与访问控制。
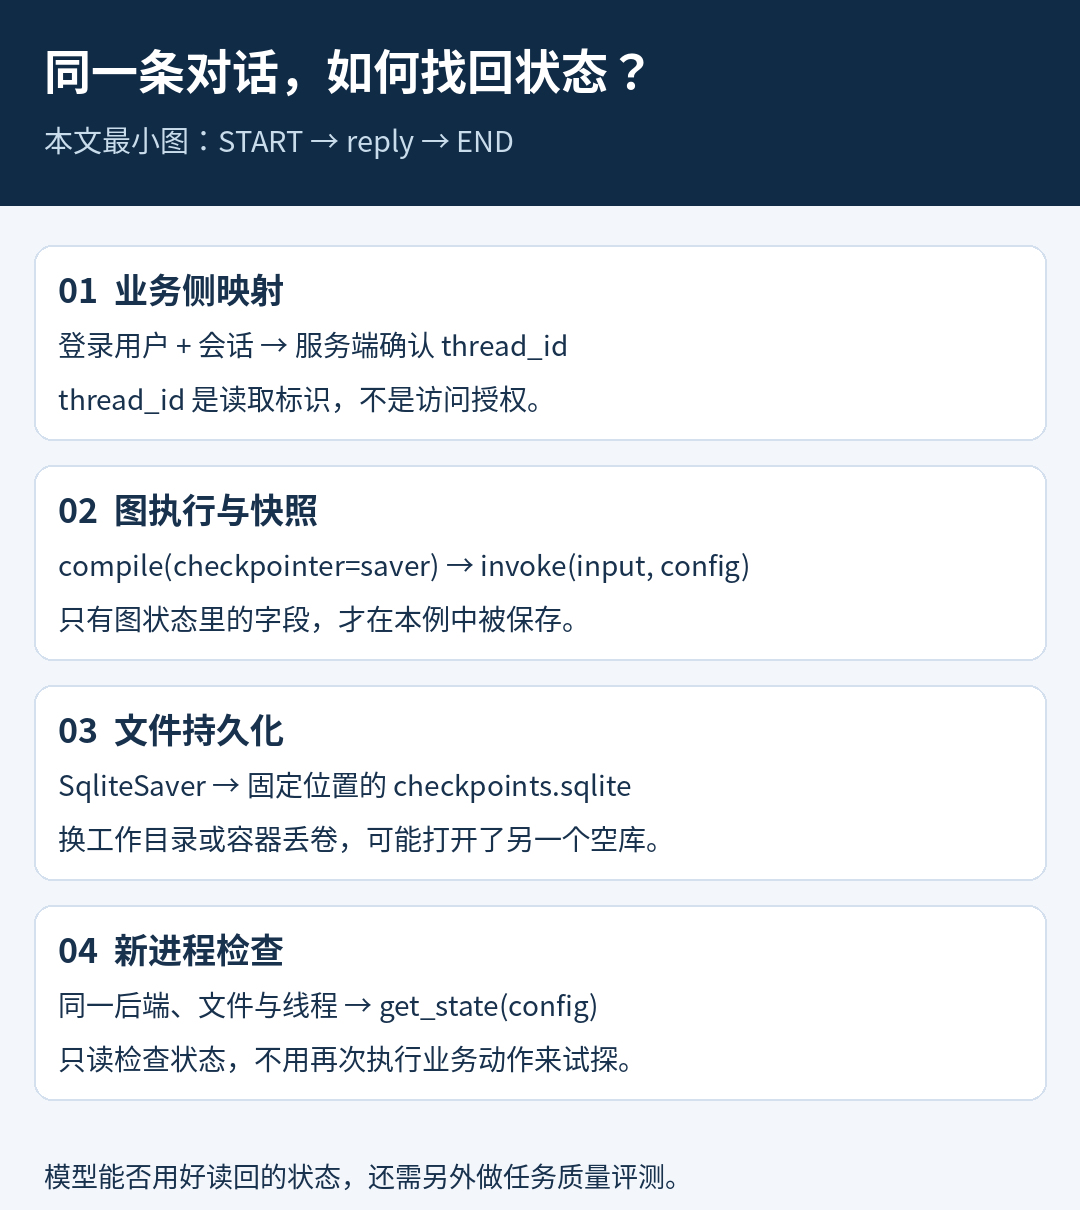
图 2:线程映射、图状态、存储位置和读取动作是四个独立检查点;模型是否正确使用读回的信息,是下一层验收。
03|关键实验:每条命令都是一个新进程
下面不是在同一个 Notebook 变量里反复调用。
每次执行 python demo.py ... 都会启动一个进程,命令完成后退出;下一条命令重新创建图和 saver。
实验 A:内存后端写入成功,退出后再读
python demo.py --backend memory --thread demo-001 --text first
python demo.py --backend memory --thread demo-001 --inspect
本地实际输出,按命令顺序:
{"history": ["first", "ack:first"], "steps": 1}
{}
第一条输出说明这一轮图执行成功。
第二条说明新进程里重新创建的内存保存器没有旧检查点。第一条没有报错,和第二条能恢复,是两件事。
如果只在同一个进程中测试,就可能漏掉这个差异。
实验 B:文件后端,用同一文件和线程重新读取
python demo.py --db ./data/checkpoints.sqlite --thread demo-001 --text first
python demo.py --db ./data/checkpoints.sqlite --thread demo-001 --inspect
本地两次输出都是:
{"history": ["first", "ack:first"], "steps": 1}
这次读回来自前一个进程写入的 SQLite 文件,不依赖前一个进程里的 Python 变量。
再启动第三个进程追加输入:
python demo.py --db ./data/checkpoints.sqlite --thread demo-001 --text second
python demo.py --db ./data/checkpoints.sqlite --thread demo-001 --inspect
两次均得到:
{"history": ["first", "ack:first", "second", "ack:second"], "steps": 2}
steps=2 和保留的第一轮历史一起说明:当前执行延续了这条线程的状态。
本例验证的是顺序写入、正常退出后的跨进程读取,没有测试断电、进程被强杀、多机并发或模型对历史的理解质量。
04|故意让它“失忆”:换线程、换路径、缺少标识
条件一:数据库没换,线程换了
python demo.py --db ./data/checkpoints.sqlite --thread demo-002 --inspect
本地输出为 {}。
这不能直接证明数据库坏了,它首先说明我们读取的是另一条线程,而这个实验还没有给它写过检查点。
如果你的前端每次刷新都重新生成随机 ID,就应先检查请求中的线程映射,而不是先更换模型。
条件二:线程没换,文件路径换了
python demo.py --db ./data/another.sqlite --thread demo-001 --inspect
在这个空实验目录下,本地输出同样为 {}。
更隐蔽的版本是:开发时从项目根目录启动,部署后从另一个工作目录启动,相同的 ./data/checkpoints.sqlite 字符串实际指向了另一个位置。
容器场景还需核对文件是否放在持久卷上,重建后是否仍能访问,以及多个副本是否真的共享预期后端。
看到同一个文件名,不足以证明读的是同一个存储。
条件三:编译时有保存器,调用时没有检查点标识
本地另做了一个错误路径测试,调用带内存 checkpointer 的图时未提供所需配置,实际收到:
ValueError: Checkpointer requires one or more of the following 'configurable' keys: thread_id, checkpoint_ns, checkpoint_id
这个实验采用 thread_id 路径,因此要在每次相关调用中传入:
config = {"configurable": {"thread_id": "demo-001"}}
如果你在别处封装了调用入口,检查配置有没有在传递过程中被覆盖或丢掉;不要只确认创建图的那一行写了 checkpointer。
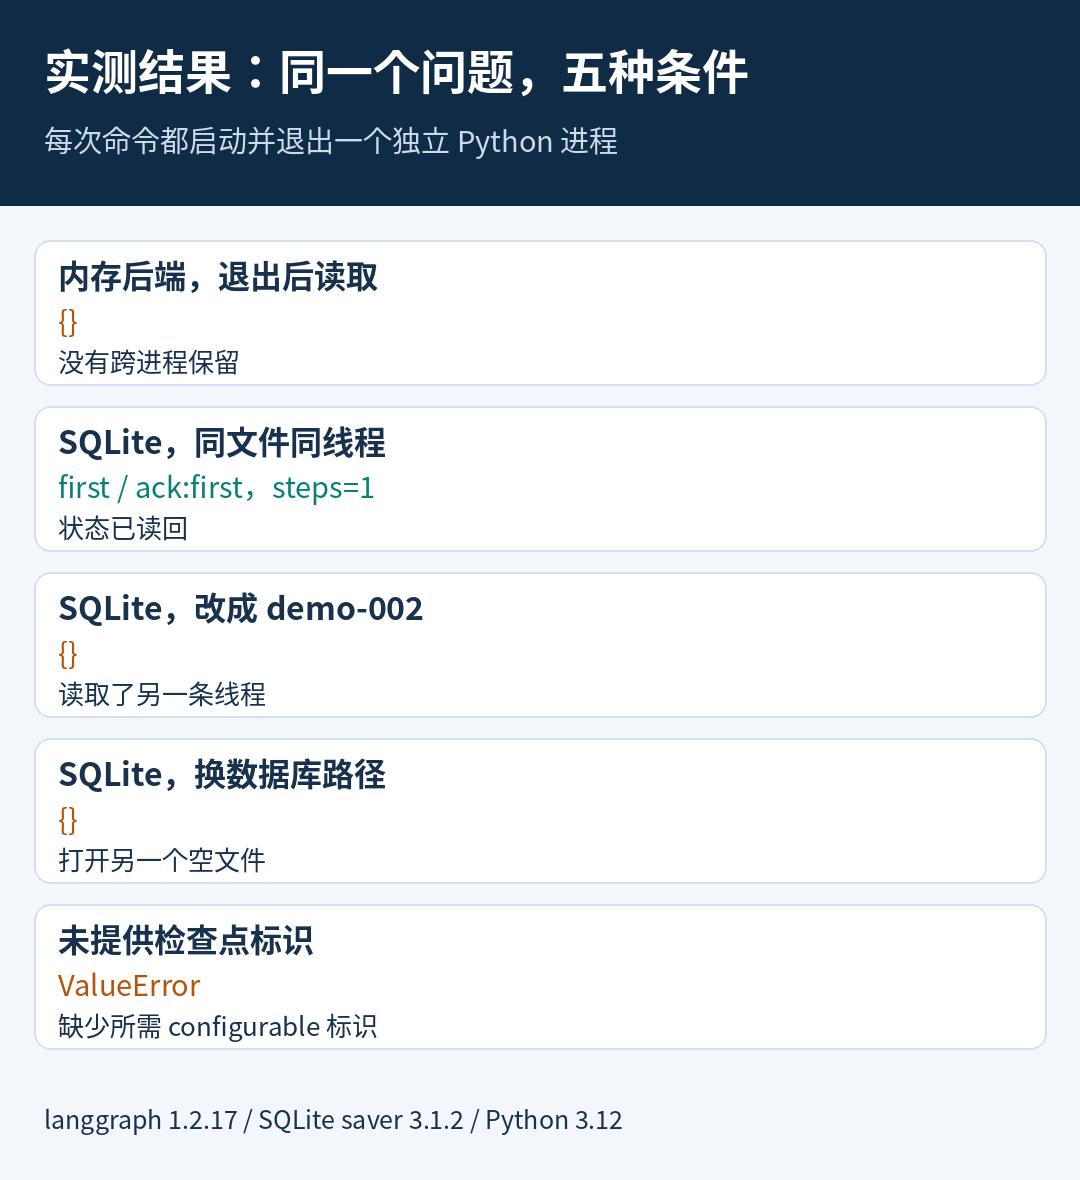
图 3:真实本地实验结果,不是模型准确率或生产可靠性测试。空状态需要结合读取条件解释。
05|一张排障表:从现象倒查,别一口气改五处
| 现象 | 先检查什么 | 怎样验证 |
|---|---|---|
| 同一进程正常,重启就没历史 | 是否仍用内存 saver | 换成新进程读取,不能只重跑 Notebook 单元格 |
| SQLite 文件存在,状态仍为空 | 线程是否一致、是否打开同一绝对路径 | 打印脱敏线程映射和运行目录,核对实际后端 |
| 第二轮只剩最新输入 | 状态字段更新与 reducer 规则 | 检查持久化前后字段,不只看最终自然语言回答 |
| 本地正常,容器重建后丢失 | 文件位置、持久卷与实例拓扑 | 在同一部署方式下做重建后读取实验 |
| 恢复状态后,邮件或发布动作重复 | 外部副作用与结果核验机制 | 核对业务动作 ID、外部结果与应用侧幂等策略 |
| 换线程就“不认识用户” | 是否混淆线程状态与跨线程数据 | 先定义数据作用域,再决定是否需要 store |
排查时先固定模型与业务输入,只改一个条件。
如果你同时改了保存器、线程生成方式、数据库路径和提示词,就算最后看起来好了,也很难知道哪个改动真正生效。
最容易误解的一点:持久化成功,不保证外部动作只执行一次
本例中的 reply 没有副作用,重复执行最多改变演示状态。
真实节点若会发邮件、扣款或公开发布,重新执行可能产生第二次外部效果。检查点保存图状态,并不能替所有外部系统提供事务保证。
因此需要另外设计业务动作标识、执行前后核验,以及在“请求超时但结果未知”时先查结果的处理路径。
人工审核、暂停与恢复的进一步讨论见流式工具调用与人工审核详解。
06|从本地实验走向上线,还差哪些验收?
这个 SQLite 方案适合用来学习、开发和验证状态路径;不能仅凭上面的几次命令,就把它当作任意规模系统的部署结论。
官方将内存保存器说明为内存存储,将 SQLite 列为本地文件方案,并提供其他持久化后端选项;应结合部署方式选择,而不是直接把开发时的文件路径复制到多实例服务。LangGraph 持久化文档
上线前至少补做四类检查:
- **隔离:**当前用户是否只能访问允许的线程,日志是否避免泄露完整历史。
- **生命周期:**连接、工作目录、持久卷和后端配置是否在重启后仍一致。
- **恢复:**异常退出与外部动作结果未知时,系统会怎样继续;本例尚未覆盖这些情况。
- **数据治理:**检查点保留、清理、备份和恢复流程是否经过实际验证。
到这里,再去接入真实模型,分别测“状态读回来了没有”和“模型有没有正确使用它”,定位会清楚得多。
如果你的 Agent 一重启就失忆,先做一次跨进程读取:固定后端、文件和线程,再观察状态。
你遇到的是哪一种:重启丢历史、换页面像新会话,还是状态能读回但动作重复?
欢迎带上脱敏后的版本、保存器类型、线程生成方式和最小复现一起讨论;不要贴数据库密码、真实用户历史或访问令牌。
企业知识库或 Agent 项目可通过项目需求入口说明部署约束和验收任务,先把范围讲清楚。
**实验说明:**本文为本站本地原创实验与排障教程,三张图为原创制作;不调用模型 API,没有进行生产性能、并发、异常退出或外部副作用测试。全部结果均限定于上文注明的环境和顺序操作。