你给 Agent 加了一条路由规则,评测从 66.7% 涨到 83.3%。
上线后,原本会先追问的模糊请求,却被直接升级处理。
问题不一定出在评测器“判错了”。
平均分本来就允许两条改善掩盖一条退步;如果你的实验还漏了失败样本,连这个平均分都不可信。
本文从 LangChain 11 月 9 日发布的评测驱动开发文章出发,做一个无需 API Key 的 Python 实验:先拒绝不可比的数据,再逐条找出改善和退化,最后说明如何接到真实 Agent 流程里。
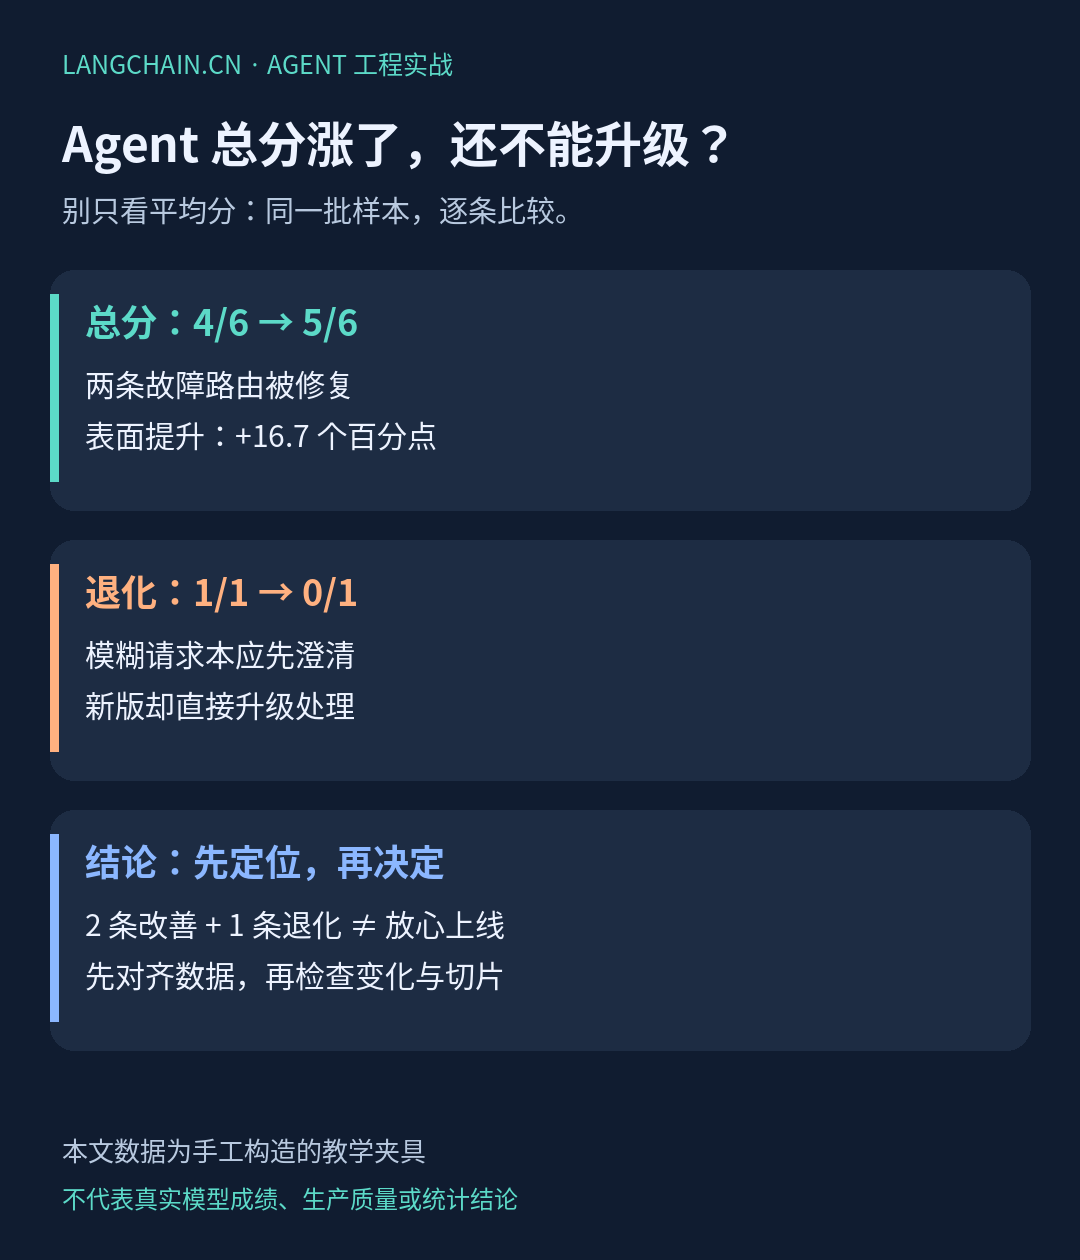
图 1:本文合成案例的核心矛盾——总分增加,并不代表原有能力完整保留。
阅读范围:本文检查的是路由决策记录,不测自然语言回答质量,也不连接模型、LangSmith 云服务或真实工单系统。
六条记录均为手工构造的教学夹具;代码执行结果是真实本地输出,记录本身不是模型运行结果。
一、这次 LangChain 的新文章,值得落实在哪里?
LangChain 于 2026 年 11 月 9 日发表 What Is Eval-Driven Development? How to Improve AI Agents。
文章建议先定义好行为、写评测并跑基线,再修改 Agent,比较每个样本的变化;同时提醒开发者保留已有能力,避免只追平均分。
本文沿着这个思路补一层原创工程实现:两次运行先满足同一套数据契约,才有资格进入比较。
这与我们此前的评测发布门禁教程分工不同。
前一篇侧重权限、结果状态与发布约束;这一篇解决实验比较时的样本对齐、分母漂移和能力退化定位。
二、先把“正确”说清楚,再讨论模型好不好
假设你在做一个企业知识助手,先判断用户意图,再交给后续执行器。
本例只有三种路由:
| 路由 | 含义 | 判断边界 |
|---|---|---|
search_docs |
查询内部文档 | 用户明确询问步骤或规则 |
clarify |
追问缺失信息 | 意图或对象不足,暂不能决定处理方式 |
escalate |
转入故障处理流程 | 用户提供足够明确的故障信息 |
escalate 在这里是一个决策标签,并不表示脚本真的创建了工单。
生产中,即使路由正确,也仍需另行检查执行权限、参数、审批与最终业务状态。
我们先写下六条规格,再构造两批结果。
| 稳定 ID | 示例输入意图 | 期望路由 | 基线 → 候选 |
|---|---|---|---|
howto |
如何查看索引构建进度? | search_docs |
正确 → 正确 |
policy |
索引保留策略是什么? | search_docs |
正确 → 正确 |
boundary |
这个索引是不是有问题? | clarify |
正确 → 错误 |
incident-a |
指定任务连续三次失败,附任务号与错误码 | escalate |
错误 → 正确 |
incident-b |
指定服务持续不可用,附时间与监控告警 | escalate |
错误 → 正确 |
incident-c |
指定构建卡住超时,附任务号和日志 | escalate |
正确 → 正确 |
表中的中文输入用于解释规格;下面代码直接保存已产生的路由记录,不实现识别这些中文请求的模型或规则。
本实验也没有验证“改一段 prompt 就能得到这些输出”。
假设一个候选版本扩大了故障路由的适用范围,可能修好两条故障处理,却把模糊意图也收进来了。
这只是待真实 trace 验证的原因假设,不能从六条标签记录直接证明。
基线正确 4 条,候选正确 5 条,提升 1/6,即约 16.7 个百分点。
但 boundary 从正确变错误,恰好损失了“信息不足先追问”的能力。
三、比平均分更危险的,是悄悄变小的分母
先别急着写 new_score - old_score。
评测数据进入汇总时,至少要守住下面三件事。
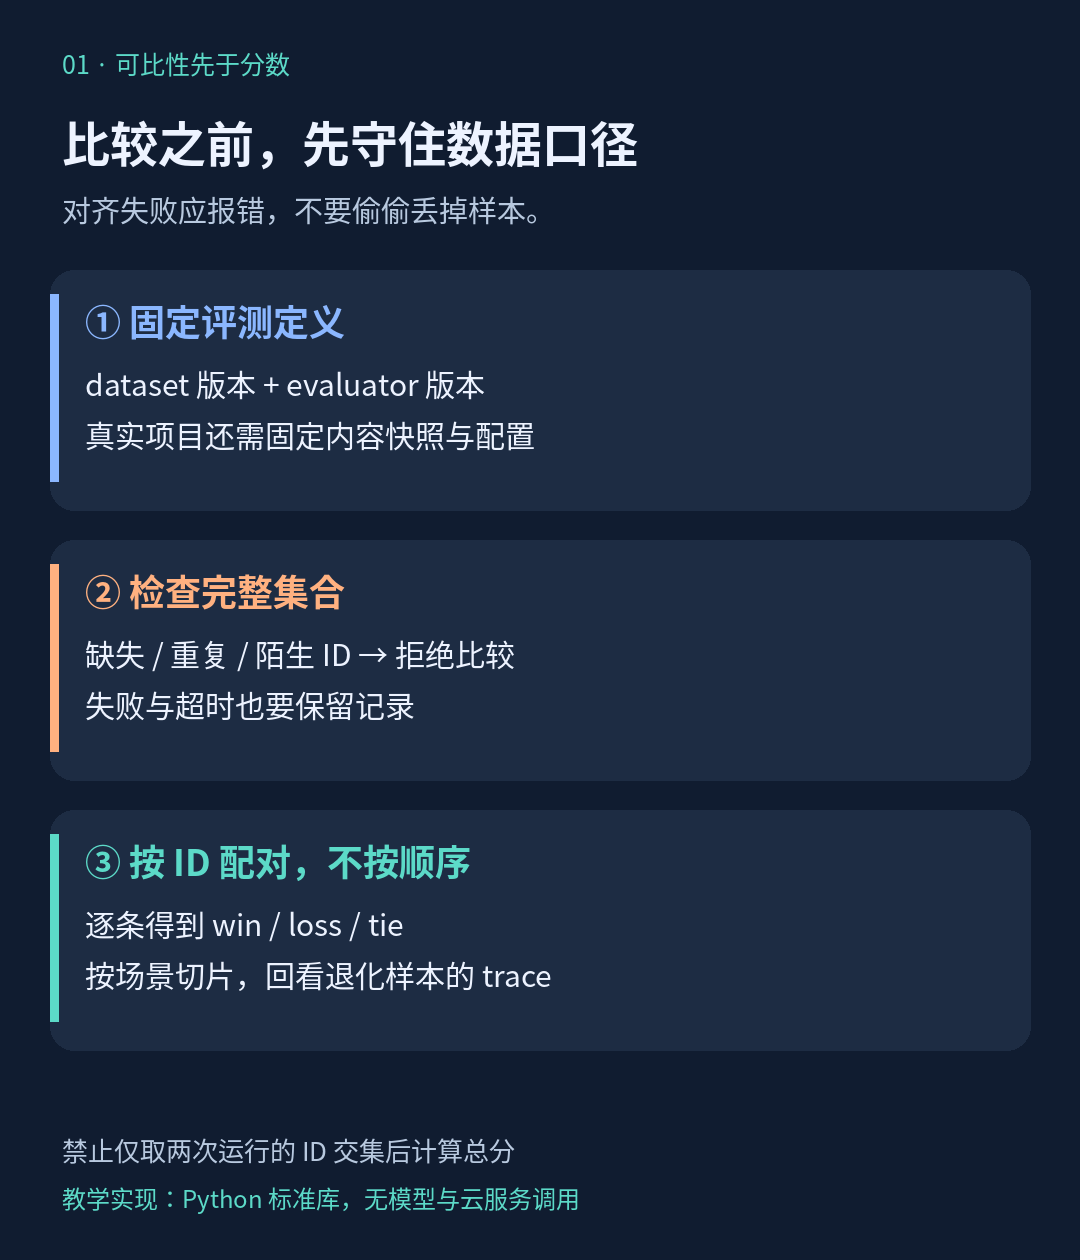
图 2:固定定义、校验完整集合、按稳定 ID 配对;任何一层失败,都不应该默默生成“提升报告”。
1. 缺一条记录,不等于那条可以忽略
如果候选版本的 boundary 超时,而导出文件只保留成功结果,候选就可能看起来 5/5 全对。
这时再与基线 4/6 对比,分母已经改变。
尤其要警惕把两个结果表做 inner join:它只留下两边都有的 ID,消失的样本会一起从报表消失。
本例要求两边都完整覆盖预定六个 ID,否则直接抛异常。
真实系统应把超时也写成一条带状态的记录,再按预先确定的规格计失败、单独报告基础设施错误,或重跑整个可比实验。
本文没有实现超时状态模型;缺记录会报错,需要先补齐证据,不能把报错解释为“模型一定失败”。
2. 重复 ID 不能用字典转换掩盖
如果原始数据有两条相同 ID,直接 {r['id']: r for r in runs} 会让后写入的覆盖前一条。
先用 Counter 检查每个 ID 恰好出现一次,再转换成字典,才能保留对重复输入的拒绝能力。
多次重复运行是另一种数据模型,应使用 (case_id, repetition_id) 唯一键,而不是允许重复 ID 混进单次比较。
3. 同名数据集,不一定还是同一道题
本文用 dataset 和 evaluator 两个版本标签做最小检查。
这是演示约定,不能防止“标签没变、实际内容已经变了”。
生产环境应保存不可变数据快照或规范化后的内容哈希,以及评测器代码版本、检索语料快照、工具配置和模型参数。
只改变你这轮想研究的变量,其他差异必须明确记录。
如果两个候选同时改变模型、提示词和知识库,最多能比较整体方案,不能把提升归因给某一条 prompt。
四、完整代码:只用 Python 标准库,跑一次看清楚
本地运行环境为 Python 3.12.3;无需安装第三方依赖。
保存为 compare.py,执行:
python3 compare.py
"""Synthetic routing records; no model calls or production measurements."""
import json
from collections import Counter

CASES = [
    ('howto', 'docs', 'search_docs'),
    ('policy', 'docs', 'search_docs'),
    ('boundary', 'ambiguous', 'clarify'),
    ('incident-a', 'incident', 'escalate'),
    ('incident-b', 'incident', 'escalate'),
    ('incident-c', 'incident', 'escalate'),
]
MANIFEST = {'dataset': 'routing-v1', 'evaluator': 'exact-action-v1'}


def fixture(version):
    actions = {
        'baseline': ['search_docs', 'search_docs', 'clarify',
                     'search_docs', 'search_docs', 'escalate'],
        'candidate': ['search_docs', 'search_docs', 'escalate',
                      'escalate', 'escalate', 'escalate'],
    }[version]
    return {**MANIFEST, 'runs': [
        {'id': case[0], 'action': action}
        for case, action in zip(CASES, actions)
    ]}


def aligned(batch):
    if any(batch.get(k) != v for k, v in MANIFEST.items()):
        raise ValueError('dataset/evaluator mismatch')
    runs = batch.get('runs')
    if not isinstance(runs, list):
        raise ValueError('runs must be a list')
    if any(not isinstance(r, dict)
           or not isinstance(r.get('id'), str)
           or not isinstance(r.get('action'), str) for r in runs):
        raise ValueError('malformed record')
    counts = Counter(r['id'] for r in runs)
    if set(counts) != {c[0] for c in CASES} or any(n != 1 for n in counts.values()):
        raise ValueError('missing, duplicate or unexpected IDs')
    return {r['id']: r['action'] for r in runs}


def compare(baseline, candidate):
    b, c = aligned(baseline), aligned(candidate)
    rows = []
    for case_id, group, expected in CASES:
        before, after = b[case_id] == expected, c[case_id] == expected
        change = ('tie_pass' if before else 'tie_fail') if before == after else (
            'win' if after else 'loss')
        rows.append({'id': case_id, 'slice': group,
                     'before': before, 'after': after, 'change': change})
    slices = {}
    for group in sorted({r['slice'] for r in rows}):
        items = [r for r in rows if r['slice'] == group]
        slices[group] = {'n': len(items),
                         'before': sum(r['before'] for r in items),
                         'after': sum(r['after'] for r in items)}
    losses = [r['id'] for r in rows if r['change'] == 'loss']
    return {'n': len(rows), 'baseline': sum(r['before'] for r in rows),
            'candidate': sum(r['after'] for r in rows),
            'wins': [r['id'] for r in rows if r['change'] == 'win'],
            'losses': losses, 'slices': slices,
            'accept': not losses and all(r['after'] for r in rows)}


if __name__ == '__main__':
    print(json.dumps(compare(fixture('baseline'), fixture('candidate')),
                     ensure_ascii=False, indent=2))
这里有两个值得特别关注的实现选择。
第一,aligned() 必须先完成版本、记录结构和集合校验,再开始评分。
未通过校验时抛 ValueError,主程序会以非零状态结束;不会输出一个误导性的接受结论。
第二,compare() 按固定的 CASES 顺序访问 ID,不按文件里记录的行号配对。
异步执行返回顺序可能变化,只要 ID 完整且唯一,这种变化就不应影响结果。
before 和 after 是同一规格下的布尔分数。
从错到对叫 win,从对到错叫 loss;都对和都错分别是 tie_pass、tie_fail。
保持失败也需要关注,它并不会因为“没有退步”就变成可接受。
五、实际输出:涨分的原因与不能升级的原因同时存在
{
  "n": 6,
  "baseline": 4,
  "candidate": 5,
  "wins": [
    "incident-a",
    "incident-b"
  ],
  "losses": [
    "boundary"
  ],
  "slices": {
    "ambiguous": {
      "n": 1,
      "before": 1,
      "after": 0
    },
    "docs": {
      "n": 2,
      "before": 2,
      "after": 2
    },
    "incident": {
      "n": 3,
      "before": 1,
      "after": 3
    }
  },
  "accept": false
}
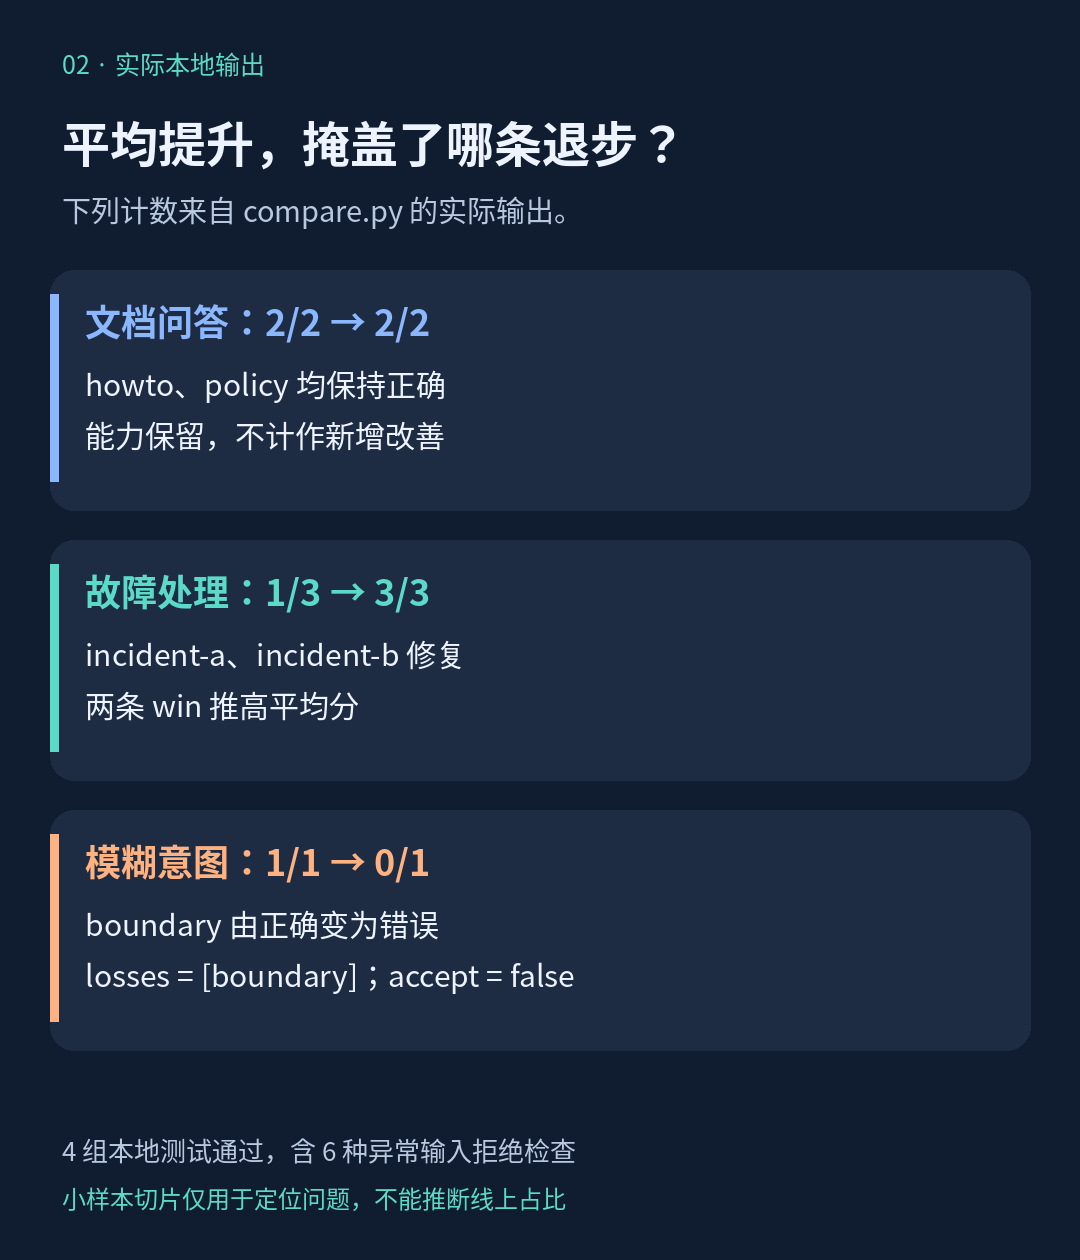
图 3:按场景分组后,故障处理的改善与模糊意图的退化同时显现;这些是教学计数,不是线上流量比例。
结果里的 wins 是两条修好的故障路由,losses 则明确指向 boundary。
分组结果显示 docs 保持 2/2,incident 从 1/3 到 3/3,而 ambiguous 从 1/1 到 0/1。
本例采用刻意严格的教学策略:全部样本通过且没有逐条退化,才令 accept 为真。
它不是通用生产上线标准,也没有统计显著性含义。
真实项目可以为非关键场景设置经过审定的容忍范围,为高风险能力单独设硬约束,但应在看到候选结果前确定规则。
不能因为这轮失败了,才临时降低阈值。
如果只修正候选中 boundary 的记录为 clarify,这个比较器会给出接受结果。
这只能证明比较逻辑能识别“退化消除”的夹具,不能证明任何真实模型已经学会澄清。
六、怎样接到 LangChain / LangGraph 项目里?
你不必先购买平台或重写 Agent。
先在现有运行器旁边补一层标准化导出,让每条样本都能生成下列记录:
{
  "id": "boundary",
  "action": "clarify"
}
id 来自评测数据集,不能用本次运行新生成的 trace ID 代替;trace ID 应作为另一个字段保留,用于定位具体执行。
action 应取自明确的路由节点输出或结构化工具决策,不要靠最终回复里是否出现“工单”二字来猜。
如果你的 Agent 允许先搜索再追问,本例的单个 action 标签就不足以表达行为。
应先把规格改成允许的路径、禁止动作和终态条件,再更换评测器版本并对基线与候选重新评分。
不要把复杂轨迹压成一个随意标签,再把标签命中率称为端到端成功率。
在 LangGraph 中可以选择稳定的路由节点作为观测点;在 LangSmith 中可以保留样本与运行的关联,在实验对比界面回看失败 trace。
这些是接入设计建议,本文没有调用对应 SDK,也没有验证任何特定版本的云端接口。
定位 boundary 时,建议按下面顺序看真实记录:
- 比较实际传给模型的消息、工具描述与上下文,确认候选到底改了什么。
- 找到首次出现不同决策的节点,判断是意图误判、检索证据不同,还是工具返回异常。
- 把期望行为具体化为可判定的条件,再只调整一个变量并跑回归集。
- 修复后补入未参与调参的近邻表达,检查是否只是记住了原题。
涉及真实写操作时,每条实验还应使用隔离环境或可复位的状态。
否则基线已修改的数据可能影响候选,导致比较的是不同的世界。
七、代码之外,真正影响结论的三个边界
小切片适合查问题,不适合证明普遍提升
本例模糊意图只有一条,1/1 到 0/1 足以说明“这一条退化了”,不足以估计全部模糊请求的失败率。
生产报告应给出样本数、采样方式、失败列表与切片覆盖,避免只展示大百分比。
非确定性需要重复运行,不能只比一次
真实模型同题多次可能给出不同路线。
应预先定义重复次数、保留每次失败,比较通过率及不确定性;若做配对分析,需要明确配对单位是样本还是样本的聚合结果。
单次出现一个 loss 是排查线索,不自动等于统计意义上的持续退化。
本文没有实现置信区间、显著性检验或模型随机性控制。
评测集也需要防止被“练熟”
这六条夹具全部公开可见,只是开发示例,没有任何一条能被称为未见保留集。
真正的保留集应与调参样本隔离,不在每次改 prompt 时反复查看;线上新失败经过脱敏、人工确认后再进入后续数据版本。
涉及主观回答质量时,还要校准人工与模型裁判的一致性,不能因为裁判输出一个数字就视为客观真值。
八、复现检查与继续阅读
本地除运行完整示例,还执行了 4 组 unittest 检查:平均分上升但仍能识别退化、记录乱序不改变结果、异常输入拒绝、修正退化后通过。
异常组覆盖缺失 ID、重复 ID、陌生 ID、数据版本不符、评测器版本不符和 action 类型错误六种情形。
没有进行真实模型、线上工具、并发评测或云服务测试。
最值得带回项目的一条改动是:把实验报告从“候选总分更高”改为“数据口径一致,哪些样本变好了、哪些变坏了、哪些仍然失败”。
- 热点来源:LangChain:What Is Eval-Driven Development?,发布于 2026-11-09,本文核验于 2026-11-11。
- 配套教程:Agent 评测发布门禁:权限与回归检查。
- 有写操作的 Agent 可继续阅读:LangGraph 恢复后重复执行?用业务幂等约束副作用。
你目前的评测报告会显示逐条退化,还是只显示一个平均分?
欢迎贴出脱敏后的数据结构与具体失败现象,讨论该如何定义真正可比较的实验。