故障现场: Agent 成功创建工单,暂停等人复核回执;点击“继续”以后,同一件事又多了一张工单。
本文用真实 LangGraph 中断恢复和 SQLite 写入复现这个问题,提供完整可运行代码,并讲清业务幂等键为什么必须落到执行端。
实验不调用模型、不连接真实工单系统,也不以教学结果代表生产可靠性。
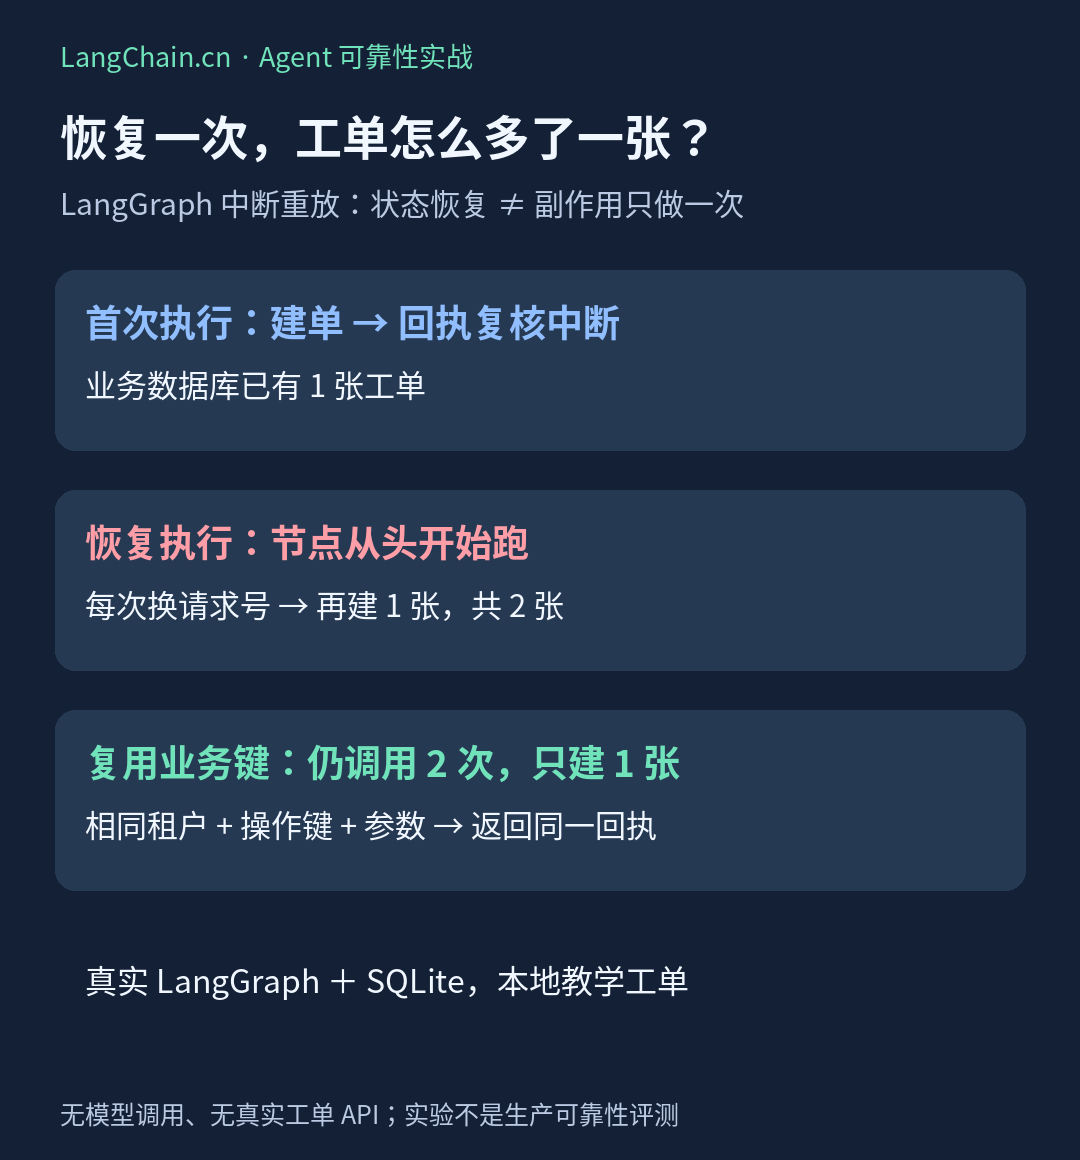
01|Agent 会恢复了,为什么业务反而重复了?
开发者给 Agent 加上 checkpoint 和人工中断,终于能暂停、继续,不用把整个任务重新跑一遍。
但日志里出现了另一个问题:节点恢复了,工单也多了一张。
这时很容易怀疑用户点了两次,或者模型重复调用了工具。
本例中,两者都不是:没有模型,只有一次恢复请求。
重复来自节点执行语义与业务写入之间的边界:暂停的节点在恢复时重新进入,而数据库里的第一张工单不会跟着图状态一起回滚。
本文想建立的判断是:“工作流可以恢复”和“业务副作用不会重复”,必须分别验证。
这个问题为什么值得现在补课?
LangChain 在 2026 年 10 月 24 日发布的 Company Harness 五个组件中,讨论了企业 Agent 的身份、记忆、代码环境与后台触发任务。
当助手从“给建议”走向“持续做事”,恢复、重试与重复投递就会直接影响业务结果。
这是本文的工程选题判断,不是说该官方案例存在重复执行故障。
具体中断机制依据 LangGraph Interrupts 官方文档:恢复时会从被中断节点的开头重新执行,因此中断前的副作用应当能够安全重放,或调整节点边界。
下面用一个小实验把这句话变成可以观察的数据。
02|先看实验结果:节点都跑两次,工单数量却不同
| 版本 | 节点实际调用次数 | 中断前工单数 | 恢复后工单数 | 两次回执 |
|---|---|---|---|---|
| 每次生成新 UUID | 2 | 1 | 2 | 1、2 |
| 复用业务操作键 | 2 | 1 | 1 | 1、1 |
这些是本地实际运行结果,不是压测统计,也不是某个模型的表现。
注意右边一行:修复后不是节点没有重放,而是业务端识别出了“这还是同一个操作”。
模型层加一句“不要重复创建工单”,无法为已经提交的数据库记录提供这种约束。
同样,前端禁用“继续”按钮只能减少重复点击,无法处理工作流恢复、网络重试和重复事件。
03|一张图看懂:中断不是保存 Python 的程序计数器
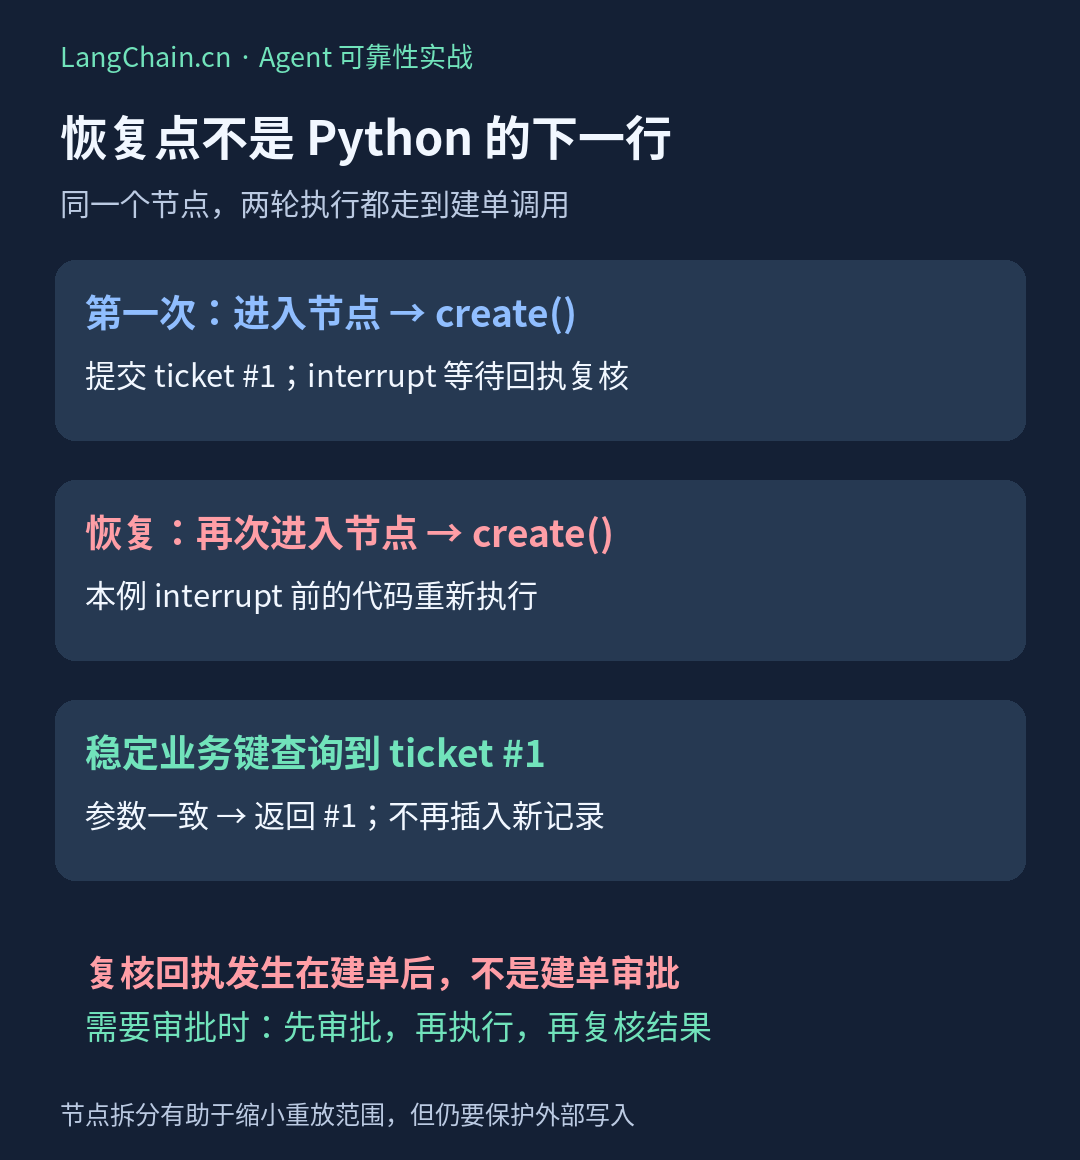
图 1:本例在建单后复核回执,恢复会重新进入节点,建单调用发生第二次。
我们的节点顺序是:
进入节点
  → 调用工单服务,提交一张工单
  → interrupt,等待人确认已查看回执
  → 返回 ticket_id 和 receipt_seen
在第一次中断时,数据库事务已经提交,但节点末尾的返回值还没产生。
因此,单靠“在返回 state 里加 ticket_id”来判断是否建过单,并不能保护这段中断前的写入。
恢复时,节点开头再次运行,再次调用工单服务。
如果这次调用重新生成一个 UUID,服务端就会把它当作另一项操作。
先说清:这里的中断不是建单审批
本例故意使用“建单后的回执复核”来观察重放。
Command(resume=True) 的 True 只表示测试驱动确认看到了回执,不赋予创建权限,也不撤销已经创建的工单。
如果你的场景是付款、发送邮件或发布内容,要求先审批,就必须把审批放在副作用之前。
幂等解决重复,不解决授权;把动作放到审批之前,本来就是另一类错误。
生产设计通常更清楚地拆成:准备参数 → 审批 → 执行 → 核对结果。
不过,节点拆开也不等于外部请求永不重复,执行端仍应能处理网络超时和任务重试。
04|业务幂等键到底是什么?
本例使用:
tenant = team-A
operation_id = request-42/create-ticket/v1
它表示 team-A 的第 42 个业务请求中,“创建工单”这一步的同一项操作。
该操作不管被调用多少次,都应该回到同一份业务结果。
为什么不能在执行节点里每次生成 UUID?
UUID 可以是好的标识生成方式,但必须在同一业务操作首次确立时生成并保留,后续重试复用它。
问题不在 UUID 本身,而在每次执行都换一个。
本例把 operation_id 放进首次输入,恢复时从同一 checkpoint 读取;这只是本地实验的键来源。
生产应由可信业务入口生成或校验它,绑定租户、操作类型和已确认的请求,不能任由模型切换键来绕开重复检查。
为什么不能直接拿 thread_id 当幂等键?
一段会话可能合法创建多张不同工单,全部共用 thread_id 会误把不同业务请求合并。
反过来,同一业务请求也可能在另一个工作线程被重试,只按 thread_id 去重又可能漏掉它。
thread_id 定位工作流状态,operation_id 定位业务动作,两者可以关联,但不应混为一谈。
为什么同键不同参数必须拒绝?
如果第一次标题是 A,第二次变成 B,却仍然返回 A 的回执,调用者可能以为 B 已经执行。
本例会比较规范化后的 payload,发现不一致就报错,并回滚当前事务。
生产还应把所有会影响结果的字段纳入比较,包括目标对象、金额、收件人或内容版本等;不能只比较便于展示的标题。
05|完整可运行代码:用 SQLite 模拟一个支持幂等的工单服务
这是社区原创教学实现,不是 LangGraph 内置的工单组件。
两组实验都调用同一个服务:故障组每次换键,修复组复用业务键。
工单服务实际执行 SQLite SQL,但不连接网络;它被当作图之外的业务存储,便于看清事务边界。
保存为 demo.py:
"""Local ticket service simulation; no model or external API calls."""
import json
import sqlite3
import tempfile
import uuid
from pathlib import Path
from typing import TypedDict

from langgraph.checkpoint.memory import InMemorySaver
from langgraph.graph import StateGraph, START, END
from langgraph.types import Command, interrupt


class Tickets:
    def __init__(self, path):
        self.conn = sqlite3.connect(path)
        self.conn.execute("""CREATE TABLE IF NOT EXISTS ticket (
            id INTEGER PRIMARY KEY AUTOINCREMENT,
            tenant TEXT NOT NULL, op_key TEXT NOT NULL,
            payload TEXT NOT NULL, UNIQUE(tenant, op_key))""")
        self.conn.commit()

    def create(self, tenant, op_key, title):
        payload = json.dumps({"title": title}, sort_keys=True,
                             ensure_ascii=False)
        self.conn.execute("BEGIN IMMEDIATE")
        try:
            row = self.conn.execute(
                "SELECT id, payload FROM ticket WHERE tenant=? AND op_key=?",
                (tenant, op_key)).fetchone()
            if row:
                if row[1] != payload:
                    raise ValueError("same key with different payload")
                ticket_id = row[0]
            else:
                cur = self.conn.execute(
                    "INSERT INTO ticket(tenant,op_key,payload) VALUES(?,?,?)",
                    (tenant, op_key, payload))
                ticket_id = cur.lastrowid
            self.conn.commit()
            return ticket_id
        except Exception:
            self.conn.rollback()
            raise

    def count(self):
        return self.conn.execute("SELECT count(*) FROM ticket").fetchone()[0]

    def close(self):
        self.conn.close()


class State(TypedDict, total=False):
    operation_id: str
    title: str
    ticket_id: int
    receipt_seen: bool


def run_case(path, stable_key):
    service = Tickets(path)
    calls = []

    def create_and_review(state):
        # Same operation must reuse the key; a fresh UUID defeats deduplication.
        key = state["operation_id"] if stable_key else str(uuid.uuid4())
        ticket_id = service.create("team-A", key, state["title"])
        calls.append(ticket_id)
        # This is receipt review AFTER creation, NOT permission to create.
        seen = interrupt({"ticket_id": ticket_id, "stage": "receipt_review"})
        return {"ticket_id": ticket_id, "receipt_seen": seen is True}

    builder = StateGraph(State)
    builder.add_node("create_and_review", create_and_review)
    builder.add_edge(START, "create_and_review")
    builder.add_edge("create_and_review", END)
    graph = builder.compile(checkpointer=InMemorySaver())
    config = {"configurable": {"thread_id": "workflow-1"}}
    paused = graph.invoke({"operation_id": "request-42/create-ticket/v1",
                           "title": "Printer offline"}, config)
    assert paused.get("__interrupt__")
    before = service.count()
    result = graph.invoke(Command(resume=True), config)
    after = service.count()
    assert result["receipt_seen"]
    assert len(calls) == 2  # The node body really ran twice.
    assert after == (1 if stable_key else 2)
    service.close()
    return {"node_calls": len(calls), "before_resume": before,
            "after_resume": after, "receipts": calls}


def main():
    with tempfile.TemporaryDirectory() as folder:
        root = Path(folder)
        naive = run_case(root / "naive.sqlite", False)
        fixed = run_case(root / "fixed.sqlite", True)
        service = Tickets(root / "bounds.sqlite")
        first = service.create("team-A", "op-1", "A")
        assert service.create("team-A", "op-1", "A") == first
        try:
            service.create("team-A", "op-1", "changed")
        except ValueError:
            conflict_rejected = True
        else:
            raise AssertionError("changed payload must be rejected")
        service.create("team-A", "op-2", "A")
        service.create("team-B", "op-1", "A")
        assert service.count() == 3
        service.close()
        print(json.dumps({"naive": naive, "fixed": fixed,
                          "payload_conflict_rejected": conflict_rejected,
                          "distinct_operations_and_tenants": 3}, indent=2))


if __name__ == "__main__":
    main()
怎样运行?
建议在独立虚拟环境中安装,避免更改现有项目依赖:
python -m venv .venv
# Linux / macOS
source .venv/bin/activate
python -m pip install "langgraph==1.2.17"
python demo.py
Windows 用户可按其终端使用虚拟环境的对应激活脚本。
本次实际环境为 Python 3.10.21、langgraph 1.2.17、SQLite 3.53.1,固定的是已验证版本,不代表它是当前所有项目的最佳或最新选择。
完整实际输出
{
  "naive": {
    "node_calls": 2,
    "before_resume": 1,
    "after_resume": 2,
    "receipts": [
      1,
      2
    ]
  },
  "fixed": {
    "node_calls": 2,
    "before_resume": 1,
    "after_resume": 1,
    "receipts": [
      1,
      1
    ]
  },
  "payload_conflict_rejected": true,
  "distinct_operations_and_tenants": 3
}
程序还用断言验证了以下边界:
- 两组节点都实际调用了两次,不能把“没有发生重放”冒充修复。
- 同一个租户、同一个键和参数,返回相同工单 ID。
- 相同键改标题,抛出 ValueError。
- 不同业务键可以独立建单。
- 不同租户使用同一键,不会互相合并。
这是对本地逻辑的检查,不是并发压测或故障恢复完整性证明。
06|最关键的修复,不是“先查一下”,而是同一事务
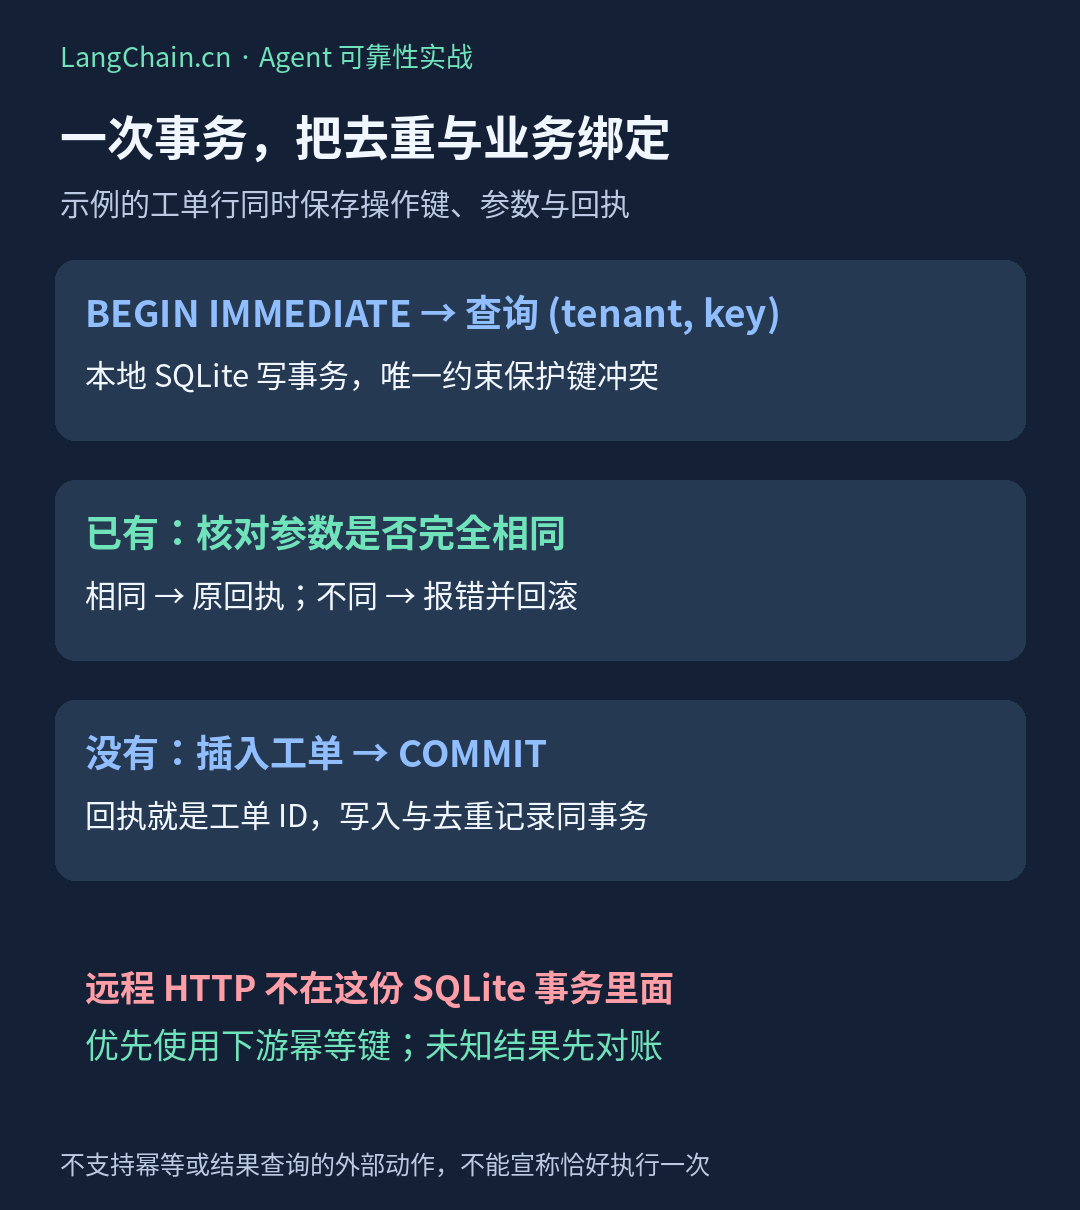
图 2:本例把业务写入和操作键放在同一行,以一次事务生成或返回回执。
1. 查询、检查、写入必须形成一个受保护的过程
如果只是先 SELECT,再在另一个不受保护的步骤 INSERT,两个并发调用都可能先读到“不存在”。
本例使用 BEGIN IMMEDIATE 开启 SQLite 写事务,并由 UNIQUE(tenant, op_key) 约束最终的键唯一性。
事务内先查已有记录;有记录就核对 payload 并返回 ID;没有记录才插入,成功后提交。
异常则回滚,因此参数冲突不会破坏之前那张已存在的工单。
2. 为什么这里不单独建一张“已执行”表?
本例直接让工单行保存 tenant、操作键和 payload,工单 ID 就是回执,避免演示中出现两份彼此可能不一致的记录。
实际系统可以有独立的幂等表,但它与同数据库内的业务写入应遵循同一个原子提交设计。
如果先记“已完成”,业务动作却没执行,会漏单;先执行动作,晚一点才记完成,又留下重复窗口。
3. 这段实现能直接扛生产并发吗?
不能据本例下结论。
SQLite 写锁会串行化写事务,连接共享、多进程竞争、忙等待与超时策略都没有压测。
生产数据库应按实际事务隔离级别、唯一约束和冲突处理实现;不能把 BEGIN IMMEDIATE 原样搬到 PostgreSQL 或 MySQL。
本例没有连接池、迁移工具、认证层、审计、回执保留期或幂等键过期策略,这些都需要业务定义。
07|换成远程 API 后,为什么本地事务还不够?
如果 create() 里面改成远程 HTTP,最棘手的情况是:
下游已经建单成功
  → 响应在网络中丢失
  → 本地还没保存回执
  → 调用方只看到超时
这时超时意味着结果未知,不意味着操作没发生。
你无法用本地 SQLite 的 rollback 撤销已经提交到远端的工单。
可以怎样设计?
下游支持幂等键: 将稳定业务键传给下游,重试同键时返回原结果;同时确认它对参数冲突、保留期和并发调用的具体语义。
下游支持按请求标识查结果: 超时后先查询并对账,找到真实结果再更新本地状态;不要换一个新键直接重建。
下游两者都不支持: 保留未知状态和人工核查路径,明确重复风险,不能宣称“有 checkpoint 就能恰好执行一次”。
如果业务能使用事务 outbox,可把待执行意图与本地业务更新同事务提交,再由投递程序发送;但投递仍可能重复,下游或消费端仍然需要去重。
这些是改造方向,本文没有接入远程 API、消息队列或实现 outbox。
08|不要把三种“只一次”混成一个承诺
| 你观察到的事情 | 它能说明什么 | 它不能说明什么 |
|---|---|---|
| 前端只点击了一次 | 用户只触发一次交互 | 节点、网络和事件只执行一次 |
| 图完成一次恢复 | 运行时沿保存状态继续推进 | 外部写入自动回滚或去重 |
| 本地同键返回同一回执 | 本服务这条逻辑具备重复请求保护 | 所有分布式链路都恰好执行一次 |
本例用 InMemorySaver 保存 checkpoint,因此测试的是同一进程内的中断恢复。
它不会在进程重启后保留 checkpoint,也没有注入崩溃或模拟网络断线。
SQLite 是文件数据库,但实验放在临时目录里,脚本结束后会删除;不能把它描述成已完成跨进程恢复测试。
关于持久 checkpointer 的另一组实测,可以接着看 LangGraph 重启失忆与 SQLite 持久化。
09|线上重复执行,先查这六项
- 是不是同一项业务操作? 记录 request、operation、thread 与 trace 的关联,避免把合法的第二次建单错当重复。
- 幂等键是否稳定? 检查 UUID、时间戳或随机值是否在重放节点里重新生成。
- 中断前做了什么? 找出建单、发信、发布、追加记录等不可直接重放的副作用。
- 回执是谁保存的? 只有节点结束时写回 state,可能保护不了节点结束之前已提交的外部动作。
- 超时是否被当作失败? 远端可能已经成功,必须保留未知状态和核对路径。
- 相同键换参数如何处理? 应显式冲突,不能悄悄吞掉新请求或用旧回执冒充新结果。
日志优先保留操作标识、参数摘要、回执与状态,不要无必要地写入客户原文或凭据。
可以把“恢复一次后工单仍只有一张”加入 Agent 发布评测门禁,同时验证拒绝审批时动作数为零、参数变更时要求重新确认。
多租户场景还要核对身份与租户范围,参见 Agent 长期记忆隔离实战;幂等键包含租户并不自动完成身份认证。
10|真正该追求的是可核对的业务结果
一个可靠的 Agent,不是永远不会重复调用,而是在恢复与重试发生时,仍能解释“这是哪项操作、现在是什么状态、对应哪个真实结果”。
先把同一业务操作认出来,再决定是返回回执、继续等待,还是执行新动作。
如果你的企业 Agent 正在遇到重复建单、重复发信或恢复后的状态对不上,可以在 项目需求与技术合作入口提供脱敏的执行阶段、下游接口能力和验收目标,不需要公开真实订单或密钥。
也欢迎在本帖交流:你现在用的是会话 ID、工具调用 ID,还是独立的业务操作 ID 来做去重?
来源与实验说明
资料核对日期为 2026-10-30,近期讨论来自 LangChain 10 月 24 日官方文章;恢复行为依据官方 Interrupts 文档,并用固定依赖实际执行验证。
本文代码、工单场景和三张配图为社区原创教学实现,使用 AI 辅助编写、制图与校验;无模型调用、无真实工单 API、无并发与崩溃压测,不代表生产系统的可靠性保证。