一个请求先交给小模型,复杂了再交给大模型——这听起来很自然。
但你接入模型路由后,可能会发现:工具已经返回了新信息,模型却没有改选;分类器只有 0.01 的置信度,请求仍然往下执行;分类器一报错,配置好的默认模型也没有接住。
路由器负责选择模型,可靠性策略仍需要你明确设计。
LangChain 于 2026 年 11 月 11 日发布 1.5.0,将 ModelRouterMiddleware 引入主包,并标为 beta。
本文不重复昨日的安装迁移,而是实际运行这个新中间件,回答四个接入前就该弄清的问题:何时分类、分类看什么、低置信度怎么办、分类失败怎么办。
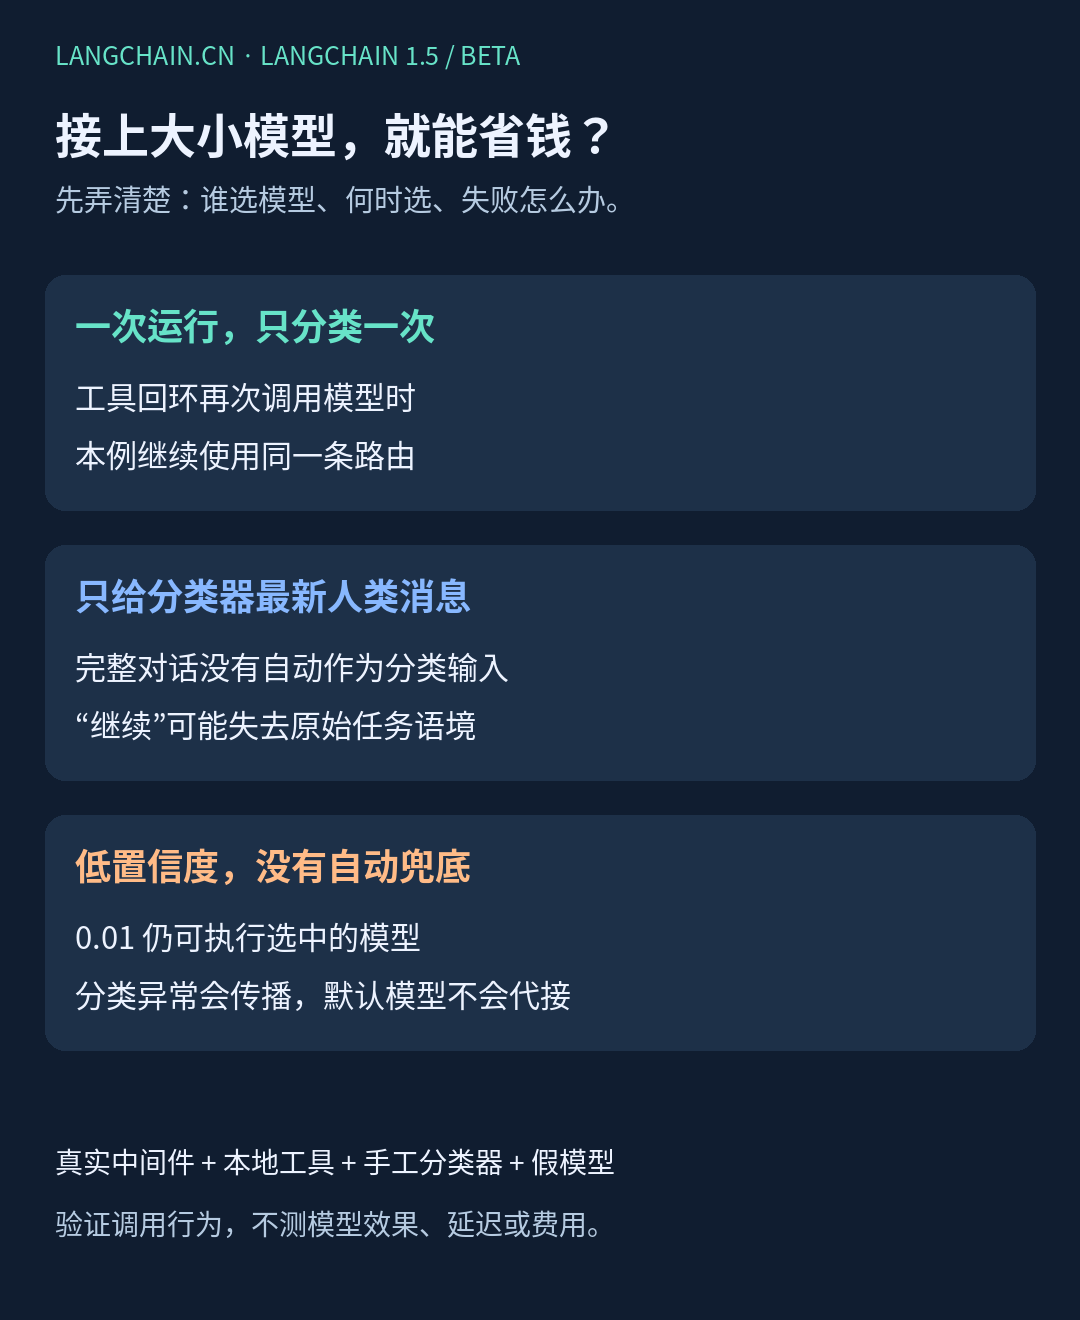
图 1:模型路由的几个行为边界,会直接影响你如何组织上下文、错误处理与回归测试。
实验范围:Python 3.12.3、langchain 1.5.0、langchain-core 1.8.0、langgraph 1.2.20。
使用真实create_agent、真实路由中间件与真实本地工具,但分类器是手工规则,聊天模型是假模型。
本文验证编排与调用行为,不测模型效果、响应速度、真实费用或省钱比例。
一、新功能真正改变了哪一层?
根据 1.5.0 官方发布记录及对应合并说明,模型路由中间件进入 langchain 主包,接收显式传入的 BaseDecisionModel 分类器。
不要直接照搬早期实验包里“省略 classifier”的示例,当前接口要求你提供它。
本例涉及三个不同角色:
| 角色 | 负责什么 | 不自动证明什么 |
|---|---|---|
classifier |
根据输入与路由规格返回标签、概率及置信度 | 标签正确、置信度已校准 |
ModelRouterMiddleware |
保存路由答案,并将模型请求改为所选模型 | 失败自动重试、低置信度自动升级 |
fast / powerful 模型 |
执行被分配的 Agent 模型调用 | 标签叫 fast 就一定快、叫 powerful 就一定强 |
真实接入时,模型对象需要满足你使用的工具调用、结构化输出等协议要求。
“都能聊天”不代表“都能在同一条 Agent 业务路径中替换”。
这篇讨论的是模型路由,不是把用户请求分发给不同业务处理器的意图路由。
也不是自动把一个多步骤任务拆成多个子 Agent。
二、读懂执行时序:一次运行先选型,工具回环继续沿用
在本次安装版本的实现中,before_agent 取出最新一条 HumanMessage,交给分类器,并把完整的 ChoiceAnswer 存入 state['model_route']。
之后的 wrap_model_call 读取这个已保存的答案,用对应模型覆盖当前请求。
这两个位置很关键:分类在进入 Agent 运行前,模型替换在每次模型调用处。
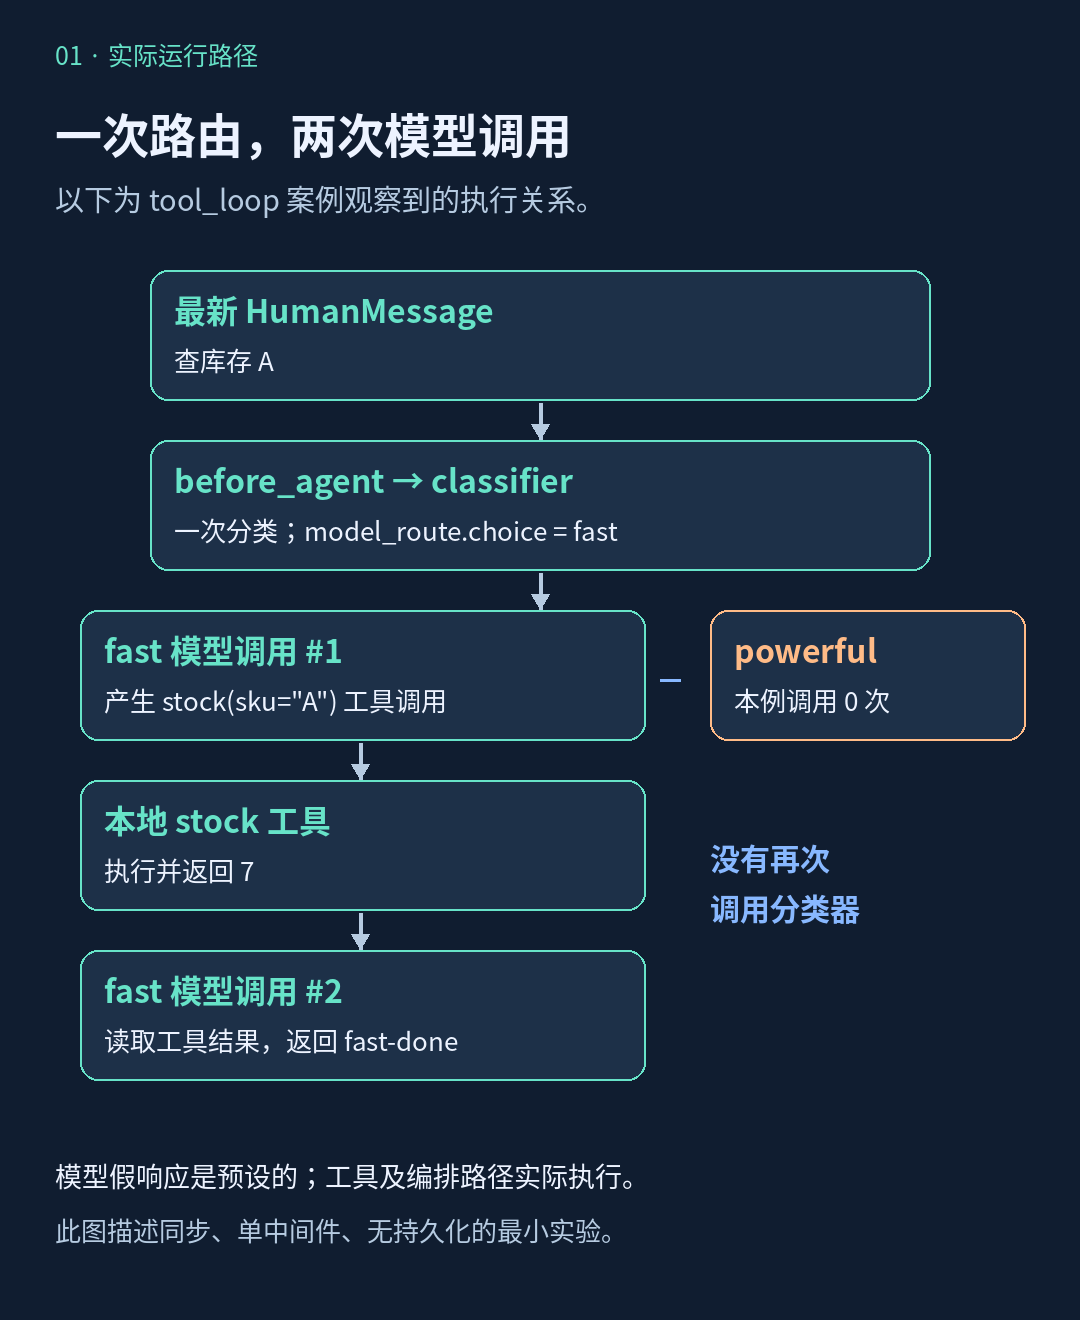
图 2:本例先选 fast,再经历模型 → 工具 → 模型的回环;分类器调用一次,fast 模型调用两次,powerful 模型未调用。
图中的两次模型响应是预设的假响应,但 Agent 确实执行了工具节点,并将本地工具结果放回消息序列。
所以我们能够验证回环次数和路由行为,不能据此证明小模型理解了库存查询。
还有一个容易混淆的粒度:一次 Agent 运行不一定等于一个模型调用,也不等于永远固定整个会话的模型。
本文每组实验都创建新 Agent 并调用一次 invoke,验证其中的工具回环;没有测试持久化线程、断点恢复、嵌套子 Agent 或跨轮会话行为。
如果你的需求是“看见工具返回大量证据之后,再升级模型”,应专门设计每次调用前的选择策略,并验证工具消息、模型状态与错误处理的一致性。
不要仅仅因为中间件名字里有 Router,就假定它会在工具回环中重新分类。
三、完整代码:真实路由中间件,加一个刻意简单的分类器
先在测试环境安装固定版本:
python -m pip install "langchain==1.5.0" "langchain-core==1.8.0" "langgraph==1.2.20" "pydantic==2.14.3"
需要 Python 3.11 或以上;如果遇到“升级成功却仍是旧版本”,可先阅读昨日的 LangChain 1.5 安装排障。
本例复用此前建立的独立虚拟环境,不修改生产服务或系统 Python。
将下面代码保存为 demo.py,执行 python demo.py:
"""Real middleware, deterministic classifier and fake chat models; no API calls."""
import json
from pydantic import Field
from langchain.agents import create_agent
from langchain.agents.middleware import ModelChoice, ModelRouterMiddleware
from langchain_core.decisions import BaseDecisionModel, ChoiceAnswer, ClassifierResponse
from langchain_core.language_models.fake_chat_models import FakeMessagesListChatModel
from langchain_core.messages import AIMessage
from langchain_core.tools import tool


class DemoDecision(BaseDecisionModel):
    model: str = 'local-rule'
    confidence: float = 0.9
    fail: bool = False
    seen: list[str] = Field(default_factory=list)

    @property
    def _provider(self):
        return 'teaching-only'

    def _classify(self, state, questions):
        self.seen.append(state.content)
        if self.fail:
            raise RuntimeError('classifier-unavailable')
        label = 'powerful' if '复杂' in state.content else 'fast'
        answer = ChoiceAnswer(type='choice', choice=label,
                              probabilities={'fast': 0.1 if label == 'powerful' else 0.9,
                                             'powerful': 0.9 if label == 'powerful' else 0.1},
                              confidence=self.confidence)
        return ClassifierResponse(model=self.model, answers={'model_route': answer})


class CountedFake(FakeMessagesListChatModel):
    calls: int = 0

    def bind_tools(self, tools, **kwargs):
        # A test adapter only. Real providers must support the actual tool protocol.
        return self

    def _generate(self, messages, stop=None, run_manager=None, **kwargs):
        self.calls += 1
        return super()._generate(messages, stop, run_manager, **kwargs)


@tool
def stock(sku: str) -> int:
    """Read a teaching inventory count without external side effects."""
    return {'A': 7}.get(sku, 0)


def build(confidence=0.9, fail=False):
    classifier = DemoDecision(confidence=confidence, fail=fail)
    fast = CountedFake(responses=[
        AIMessage(content='', tool_calls=[{'name': 'stock', 'args': {'sku': 'A'},
                                           'id': 'read-1', 'type': 'tool_call'}]),
        AIMessage(content='fast-done'),
    ])
    powerful = CountedFake(responses=[AIMessage(content='powerful-done')])
    router = ModelRouterMiddleware(
        choices={'fast': ModelChoice(model=fast, criteria='Simple task'),
                 'powerful': ModelChoice(model=powerful, criteria='Complex task')},
        instructions='Choose a suitable model.', classifier=classifier)
    agent = create_agent(model=powerful, tools=[stock], middleware=[router])
    return agent, classifier, fast, powerful


def execute(messages, confidence=0.9, fail=False):
    agent, classifier, fast, powerful = build(confidence, fail)
    try:
        out = agent.invoke({'messages': messages})
        answer = out['model_route']
        result = {'route': answer.choice, 'confidence': answer.confidence,
                  'reply': out['messages'][-1].content,
                  'tool_results': [m.content for m in out['messages'] if m.type == 'tool']}
    except RuntimeError as exc:
        if str(exc) != 'classifier-unavailable':
            raise
        result = {'error': str(exc)}
    return {**result, 'classifier_inputs': classifier.seen,
            'classifier_calls': len(classifier.seen),
            'fast_calls': fast.calls, 'powerful_calls': powerful.calls}


if __name__ == '__main__':
    cases = {
        'tool_loop': execute([{'role': 'user', 'content': '查库存 A'}]),
        'latest_only': execute([
            {'role': 'user', 'content': '复杂事故复盘,需要逐项验证'},
            {'role': 'assistant', 'content': '请继续提供信息'},
            {'role': 'user', 'content': '继续'}]),
        'complex': execute([{'role': 'user', 'content': '复杂事故复盘'}]),
        'low_confidence': execute([{'role': 'user', 'content': '查库存 A'}], confidence=0.01),
        'classifier_failure': execute([{'role': 'user', 'content': '查库存 A'}], fail=True),
    }
    assert cases['tool_loop']['classifier_calls'] == 1
    assert cases['tool_loop']['fast_calls'] == 2
    assert cases['tool_loop']['powerful_calls'] == 0
    assert cases['tool_loop']['tool_results'] == ['7']
    assert cases['latest_only']['classifier_inputs'] == ['继续']
    assert cases['complex']['powerful_calls'] == 1
    assert cases['low_confidence']['route'] == 'fast'
    assert cases['low_confidence']['fast_calls'] == 2
    assert cases['classifier_failure']['fast_calls'] == 0
    assert cases['classifier_failure']['powerful_calls'] == 0
    print(json.dumps(cases, ensure_ascii=False, indent=2))
先说明哪些是教学替身
DemoDecision 确实继承 BaseDecisionModel,会经过真实分类调用接口。
但它不读取指令来“思考”,只判断最新输入是否包含“复杂”二字:包含就选 powerful,否则选 fast。
概率 0.9 / 0.1 和 confidence 都是代码写入的教学数据。
尤其是低置信度案例,故意把 confidence 设置为 0.01,目的是观察中间件是否消费该字段作为阈值,不能把这些值理解为经过校准的预测。
CountedFake 会返回我们事先写好的模型消息。
其中 bind_tools() 直接返回自身,是让假模型参与工具回环的测试适配;这不是给不支持工具协议的真实模型添加工具能力的方法。
stock 是真实执行的本地只读函数,库存 7 是内存里的教学值,不对应任何生产库存。
Agent 确实因假模型给出的工具调用而执行它,但假模型没有自主学会何时调用工具。
四、五组实际输出,逐项拆解
{
  "tool_loop": {
    "route": "fast",
    "confidence": 0.9,
    "reply": "fast-done",
    "tool_results": [
      "7"
    ],
    "classifier_inputs": [
      "查库存 A"
    ],
    "classifier_calls": 1,
    "fast_calls": 2,
    "powerful_calls": 0
  },
  "latest_only": {
    "route": "fast",
    "confidence": 0.9,
    "reply": "fast-done",
    "tool_results": [
      "7"
    ],
    "classifier_inputs": [
      "继续"
    ],
    "classifier_calls": 1,
    "fast_calls": 2,
    "powerful_calls": 0
  },
  "complex": {
    "route": "powerful",
    "confidence": 0.9,
    "reply": "powerful-done",
    "tool_results": [],
    "classifier_inputs": [
      "复杂事故复盘"
    ],
    "classifier_calls": 1,
    "fast_calls": 0,
    "powerful_calls": 1
  },
  "low_confidence": {
    "route": "fast",
    "confidence": 0.01,
    "reply": "fast-done",
    "tool_results": [
      "7"
    ],
    "classifier_inputs": [
      "查库存 A"
    ],
    "classifier_calls": 1,
    "fast_calls": 2,
    "powerful_calls": 0
  },
  "classifier_failure": {
    "error": "classifier-unavailable",
    "classifier_inputs": [
      "查库存 A"
    ],
    "classifier_calls": 1,
    "fast_calls": 0,
    "powerful_calls": 0
  }
}
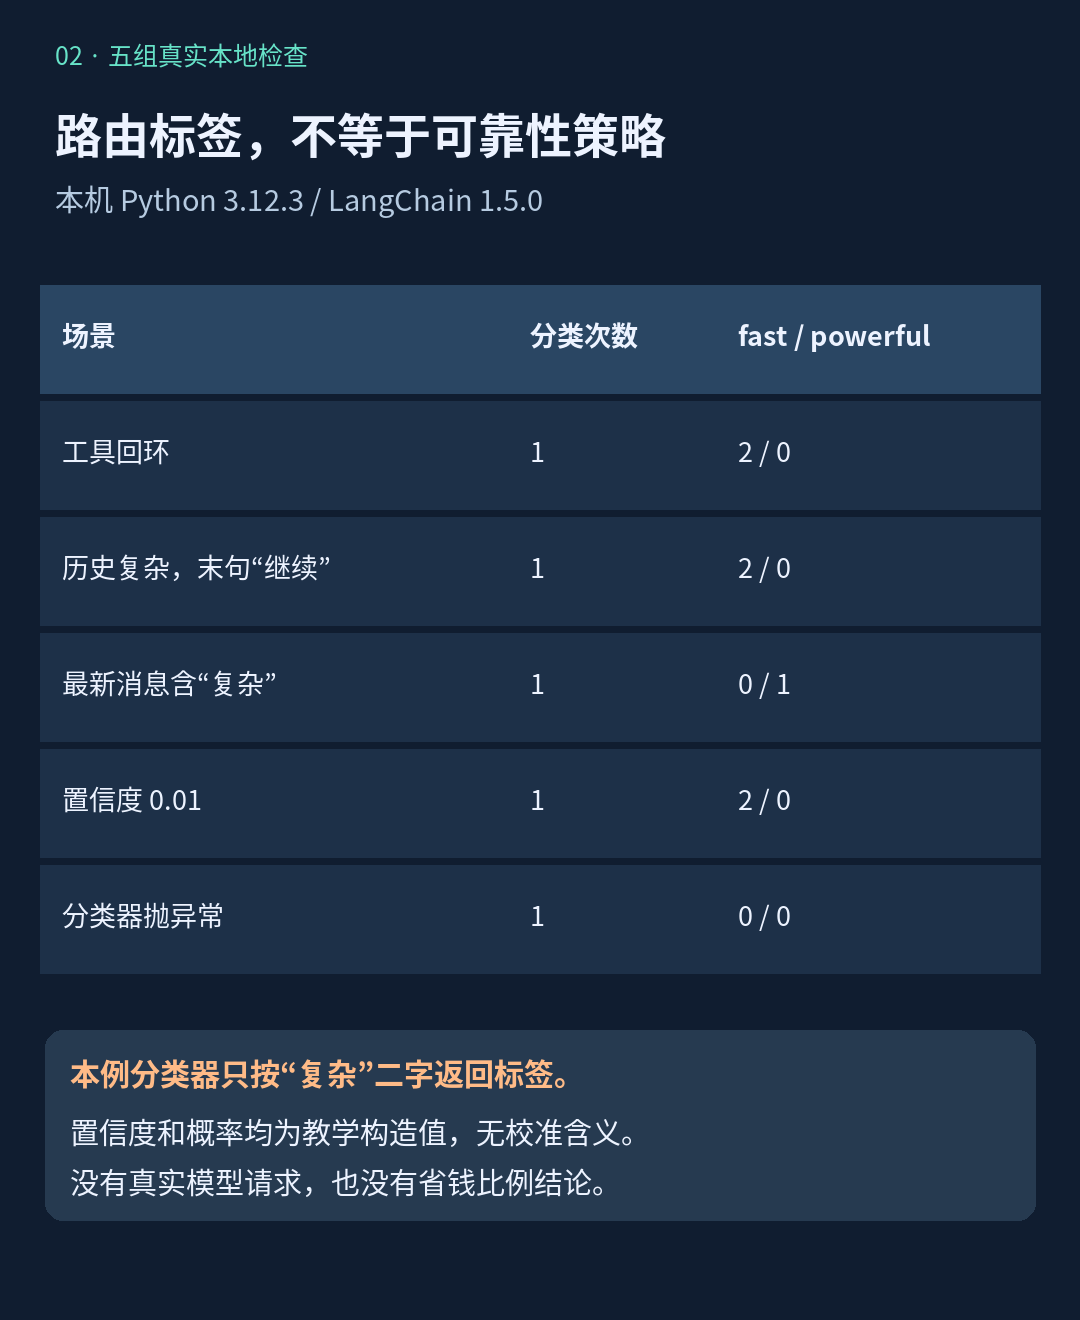
图 3:五组案例的分类次数与模型调用计数,来自本次真实本地运行;没有连接模型服务。
1. tool_loop:默认模型存在,也不意味着总会用到它
代码在 create_agent(model=powerful, ...) 中配置了 powerful。
但分类结果为 fast,实际看到的是 classifier_calls=1、fast_calls=2、powerful_calls=0。
tool_results=['7'] 则说明本地工具确实执行,结果进入了消息流。
这组结果说明路由可以覆盖初始模型选择,同时整个模型—工具回环沿用已选模型。
它没有证明 fast 比 powerful 更便宜,也没有证明所有工具执行都正确。
2. latest_only:历史消息还在,分类器却没有自动读到它
我们给 Agent 的消息里先有“复杂事故复盘,需要逐项验证”,最后一条用户消息则只有“继续”。
实际记录的 classifier_inputs 仅为 ['继续'],于是手工规则选了 fast。
这里要准确区分:历史消息没有从 Agent 状态中被删除;只是路由分类器收到的 state 是最新人类消息,而不是完整消息列表。
不能由此声称最终聊天模型也“失忆”了。
工程上真正需要问的是:最新一句是否足以代表当前任务?
如果用户经常说“继续”“按上面的要求做”,应考虑在业务层形成有来源的任务摘要,或实现显式消费相关上下文的路由逻辑,再测试摘要遗漏和注入风险。
不要在没说明语义的情况下,将内部摘要伪装成用户新授权;模型选择也不能替代工具权限校验。
3. complex:看到 0 / 1,只能证明标签映射生效
最新消息包含“复杂”,规则选择 powerful,实际 fast_calls=0、powerful_calls=1。
这是正常分支,证明标签能映射到预期模型对象。
它不证明“包含复杂二字”就是一条合理路由标准,也不证明 powerful 真的擅长事故复盘。
真实分类标准需要用实际任务样本验证,尤其是隐含难度、短请求和多轮指代。
4. low_confidence:保存置信度,不等于执行了阈值策略
confidence=0.01 时,实际仍然调用 fast 两次。
在本次固定版本、没有其他策略中间件的实验中,路由中间件没有因为低置信度而拒绝、追问或升级。
你若需要阈值策略,必须明确决定:低于什么条件时,选择更保守的模型、询问用户,还是停止执行?
阈值需要校准,不能直接把本文的 0.01、0.9 当成上线参考值。
还应记录这类策略触发率及误升级、误拦截情况,避免只是把所有请求都推给昂贵模型。
5. classifier_failure:配置默认模型,不等于配置了分类故障兜底
分类器主动抛出 RuntimeError('classifier-unavailable'),本例 fast、powerful 调用次数都为 0。
异常在进入模型调用前传播出来;脚本外层捕获这个特定异常,仅为打印可比较的结果。
生产应用不应照搬这种打印结果后就视为请求成功的处理方式。
应记录明确的失败状态,并根据业务风险决定是否重试分类、进入预先定义的保守路线或返回错误。
本例没有测试聊天模型自身超时、模型拒答,也没有叠加 ModelFallbackMiddleware。
因此,不能把分类阶段的观察扩大成所有模型故障的结论;不同故障阶段以及中间件顺序需要分别验证。
五、排障时,先对齐你预期的“路由粒度”
| 观察到的现象 | 优先检查 | 本文实验说明 |
|---|---|---|
| 工具返回后仍用同一个模型 | 你要的是每次运行选型,还是每次模型调用选型? | 工具回环没有再次调用分类器 |
| 短句被分到意外模型 | 分类器实际拿到的是最新人类消息还是任务上下文? | “继续”没有携带历史复杂任务信息 |
| 置信度很低还在执行 | 谁负责读取置信度并执行策略? | 中间件保存字段,但本例无阈值兜底 |
| 分类器故障,默认模型没接住 | 失败发生在分类前置阶段,还是模型请求阶段? | 分类失败时两个模型都未调用 |
| 本地测试可用,CI 构造就失败 | warning 是否被当作 error? | 本例首次构造时出现真实 beta 警告 |
最后一行与 beta 标记的官方说明有关:1.5.0 会在首次外部直接实例化时发出 beta 警告,warning-as-error 配置可能因此拒绝构造。
本例观察到了警告,没有实际运行 CI 的 warning-as-error 分支。
不要全局关闭所有警告来“修好”它。
更好的做法是固定依赖、审查 beta API 的使用,并让测试对预期警告作明确处理。
六、真正评估省钱之前,把分母与质量一起补齐
路由的平均开销至少要考虑分类开销、实际模型调用、重试和补救成本。
下面只是一个分析口径,不是本文测得的账单:
每个原始请求的平均模型开销
= 总分类开销 / 原始请求数
+ 所有模型调用开销 / 原始请求数
+ 补救调用开销 / 原始请求数
这里“所有模型调用”与“补救调用”应互斥统计,避免重复计费;缓存、批处理、模型供应商的实际计费口径也应纳入采集设计。
不要只按 fast / powerful 请求占比估计费用,因为同一个请求可能调用模型多次,长上下文也可能让单次开销差异很大。
更关键的是,省下费用后原任务是否仍然完成?
建议把固定数据集分为短指令、多轮指代、需要工具、复杂判断等场景,同时保留任务成功率、逐条退化、尾延迟、失败率及每个原始请求的实际开销。
比较“全部使用一个基线模型”与“开启路由”时,保持任务集、工具环境和验收规则一致。
如果只在成功请求上算平均费用,失败的请求就被从分母抹掉了。
逐条比较的方法可参考Agent 总分涨了,为什么仍不能升级?。
本文没有调用真实模型,也没有付费账单,所以不提供任何省钱比例或准确率提升数字。
七、接入前可以直接使用的验收清单
- 固定本次验证的包版本,明确 beta API 升级需要复测。
- 为每条请求记录路由输入的最少必要信息、所选标签、分类失败和模型调用计数,并对敏感上下文作脱敏与访问控制。
- 给低置信度、分类异常和模型异常分别写明策略,不能用一个“默认模型”字段代替所有故障设计。
- 用多轮指代与工具回环案例检查路由粒度,不只测试独立的短问答。
- 验证候选模型的工具协议与业务结果,路由到某模型不能自动扩大执行权限。
- 用相同原始请求集比较质量与实际开销,再决定是否扩大使用。
官方来源与本次验证范围
- LangChain 1.5.0 发布记录,2026-11-11 发布。
- 模型路由与 Auto Mode 引入主包的合并说明,本文只实验模型路由,不讨论 Auto Mode 的执行行为。
- ModelRouterMiddleware beta 标记说明,2026-11-11 合并。
本文核验于 2026-11-13,同时检查已安装 1.5.0 包内 model_router.py 的 before_agent 与 wrap_model_call 实现,并运行五组同步检查。
源码可在相同版本环境用 inspect.getsource() 查看;未来版本可能改变行为,应以固定版本测试结果为准。
未测试异步调用、持久化恢复、并发、其他中间件组合、真实分类服务、真实模型效果或账单。
你需要的是“每个请求先选一次”,还是“工具返回后还能重新选择”?
先把这个粒度写进设计,再接第二个模型,排障会容易得多。