一个上线前必须回答的问题: 100 人共用同一个 Agent,它记住的是“这个人”,还是一个所有人都能撞上的 ID?
本文用真实 LangGraph 调用与 SQLite 读写,复现“只按 user_id 过滤”导致的跨租户记忆混入,再实现身份限定的读取、写入和删除。
无需 API Key,不调用大模型;测试数据为人工构造,不涉及真实用户资料。
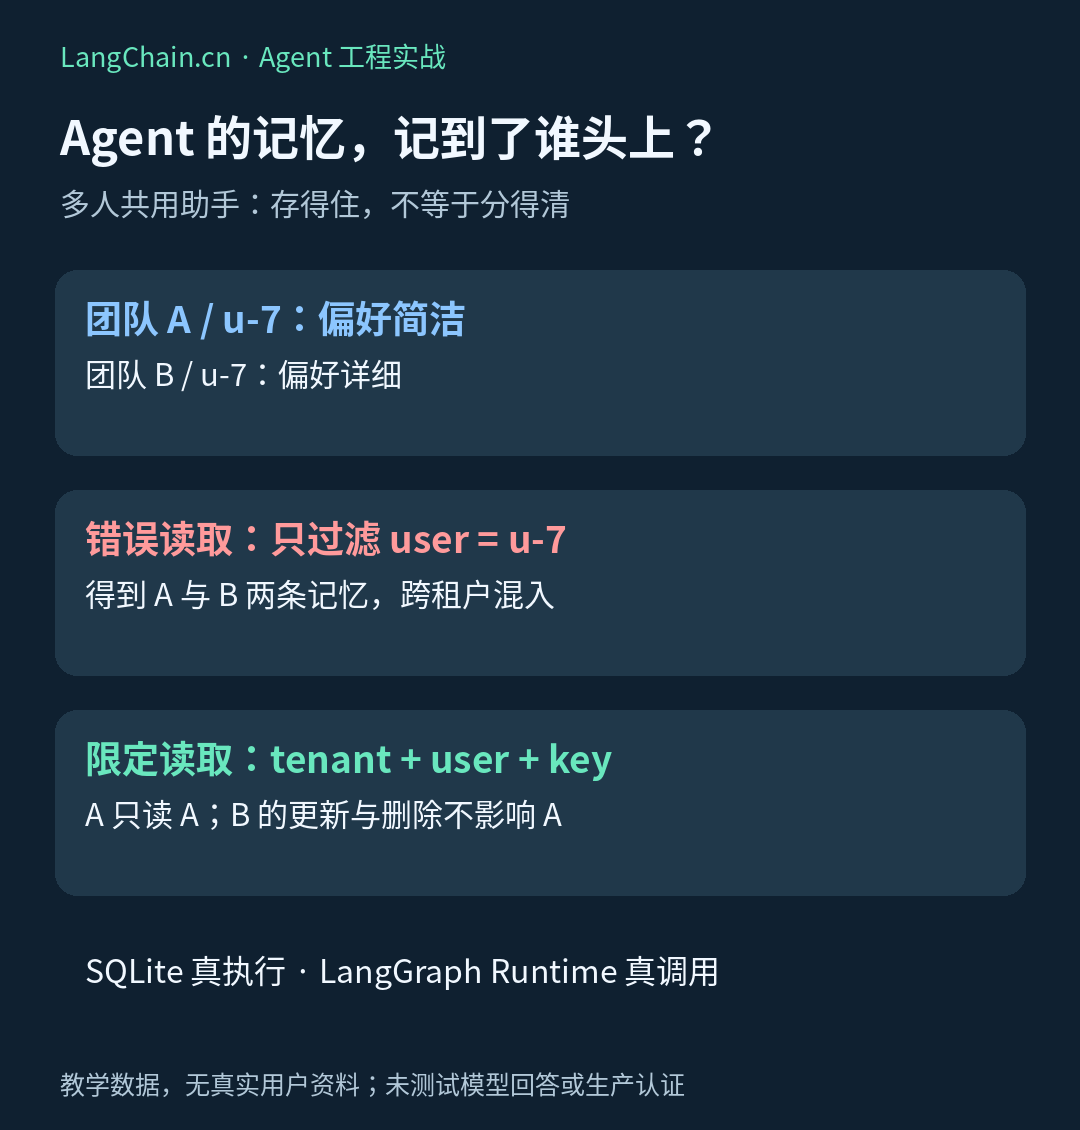
01|Agent 越来越会记事,但不一定记得对人
一个助手在单人演示里表现很好:你说“以后回答简洁一点”,下一次打开它,它真的记住了。
换成两个客户团队后,问题来了。
团队 A 有一个用户 u-7,偏好简洁;团队 B 也有一个 u-7,偏好详细。
如果查询只有 WHERE user = 'u-7',数据库会忠实地返回两个团队的记录。
数据库没坏,模型也未必幻觉,错的是你给“这个用户”下的定义。
更隐蔽的是:记忆已经被塞进模型上下文后,即使最终回答没直接引用它,隔离边界也已经失守。
所以,这类问题首先要排查数据访问路径,而不是追加一句“不要泄露其他用户信息”的 Prompt。
为什么现在值得关注?
LangChain 在 2026 年 10 月 24 日的 Company Harness 五个组件中,把调用者身份与全局/用户记忆列为企业 Agent 的核心基础设施。
随后 10 月 27 日的 设计 Agent 实战展示了多人通过 Slack 协作、每个线程使用独立沙箱、结合技能与记忆长期工作的系统形态。
这两篇文章说明了一个值得开发者提前处理的变化:助手开始从单人聊天走向多人共享的工作系统。
本文不是在报告上述产品存在漏洞。
下面是社区原创的隔离设计与故障复现,讨论的是自建 LangChain / LangGraph 应用常见的数据作用域错误。
02|先分清四个 ID:它们管的不是同一件事
| 概念 | 管什么 | 不能拿它证明什么 |
|---|---|---|
| tenant_id | 哪个客户或组织的数据边界 | 某人天然拥有该组织权限 |
| user_id | 组织内或身份系统中的用户标识 | 跨组织一定唯一 |
| thread_id | 一段会话或工作流的持久化定位 | 当前调用者有权读取这段会话 |
| memory key / namespace | 哪类记忆、存放在哪个分组 | 分组名称本身具有认证能力 |
LangGraph Memory 文档区分线程级短期状态和跨会话长期记忆。
两者可以配合,但“不同 thread_id”不会自动替你校验用户、租户以及历史线程的访问权限。
假设你用一个全局 Store 保存偏好,即使新开会话、换了 thread_id,只要长期记忆查询仍然漏掉租户条件,错误就会继续发生。
反过来,长期记忆隔离正确,也不能弥补“知道 thread_id 就能恢复别人历史状态”的接口问题。
本文只实现用户私有长期键值记忆,不启用 checkpointer,避免把会话恢复与长期记忆访问混为一谈。
03|最小复现:同一个 u-7,读出了两家公司
先看本例的数据结构:
(tenant, user, key) -> value

(team-A, u-7, style) -> A: concise
(team-B, u-7, style) -> B: detailed
(team-A, u-8, style) -> A-other: table
故障查询故意省略 tenant:
SELECT value
FROM memory
WHERE user = ? AND key = ?;
传入 u-7 与 style,本地实际得到:
["A: concise", "B: detailed"]
这不是“相似度阈值设低了”,因为本例根本没有向量检索;也不是数据库没持久化,因为两条记录都确实存在。
该问题发生在检索范围选择阶段,比排序、摘要和模型回答更早。
正确的私有读取条件应同时包含租户、用户和键:
WHERE tenant = ? AND user = ? AND key = ?
但还有一个更关键的问题:这三个参数里,谁有资格决定 tenant 和 user?
04|身份必须从服务端传入,不能由用户或模型“自报家门”
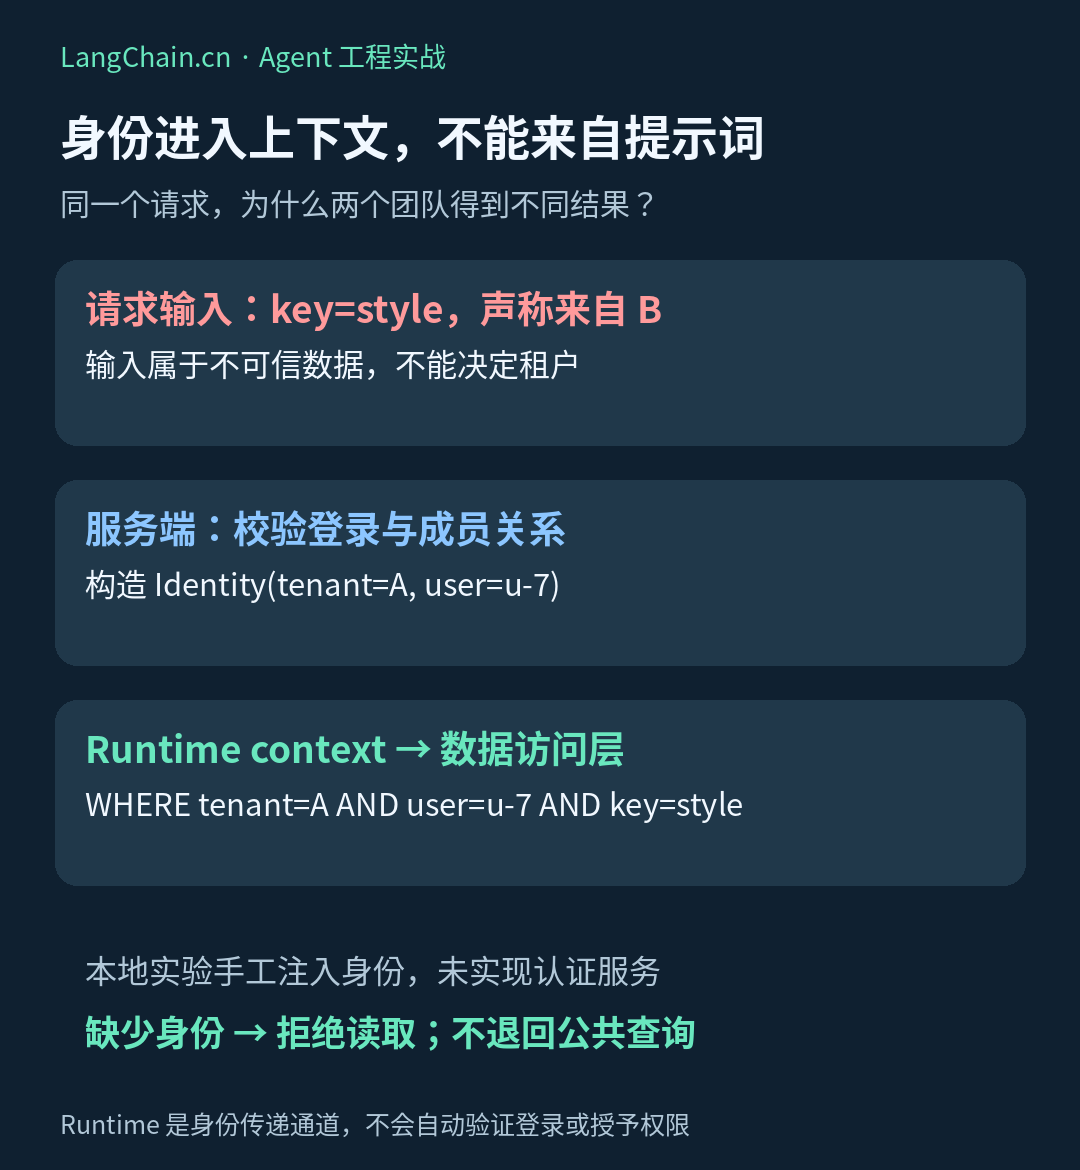
图 1:本例把身份放在 Runtime context,把请求内容放在 state;可信性来自服务端构造过程,而不是变量名。
如果接口这样写:
identity = Identity(request.body.tenant_id, request.body.user_id)
那么 SQL 即使带全了过滤条件,调用者仍可能通过更改请求体访问别人的作用域。
问题只是从“漏过滤”变成了“信任伪造身份”。
本例怎样传递身份?
节点读取 runtime.context 中的 Identity,业务输入里故意保留一个 claimed_tenant,但不使用它选择记忆范围。
测试驱动用同一个请求,分别传入 A 和 B 的身份,验证输出跟随可信上下文,而不是请求声称的租户。
LangGraph Graph API支持通过 context_schema 定义运行上下文,并在节点中使用 Runtime 读取。
Runtime context 是传递身份的通道,不是身份认证服务。
本地代码手工创建 Identity,只验证数据访问机制;生产中应先校验登录会话或令牌、组织成员关系和操作权限,再由服务端构造上下文。
如果把前端传入的身份直接包装成 dataclass,类型检查只能证明它是一个对象,无法证明它真的属于调用者。
为什么身份缺失必须报错?
“没有 user_id 就查公共区”看似友好,实际可能把认证配置错误掩盖成一次正常召回。
本例缺少身份或身份字段为空时直接拒绝访问。
共享知识必须走单独定义的策略,不作为私有记忆失败后的隐式回退。
05|完整代码:LangGraph + SQLite,不需要模型调用
保存为 demo.py。
下面的 Memory 是本教程自定义的数据访问类,不是官方 Store 实现;其数据库连接封装用于演示,不能视为阻止任意 Python 代码直接访问数据库的安全沙箱。
"""Local teaching demo. Context must be built by a trusted server."""
import json
import sqlite3
import tempfile
from dataclasses import dataclass
from pathlib import Path
from typing import TypedDict

from langgraph.graph import StateGraph, START, END
from langgraph.runtime import Runtime


@dataclass(frozen=True)
class Identity:
    tenant: str
    user: str


def scope(identity):
    if not isinstance(identity, Identity):
        raise PermissionError("trusted identity required")
    if not identity.tenant or not identity.user:
        raise PermissionError("empty identity")
    return identity.tenant, identity.user


class Memory:
    def __init__(self, path):
        self.conn = sqlite3.connect(path)
        self.conn.execute("""CREATE TABLE IF NOT EXISTS memory (
            tenant TEXT NOT NULL, user TEXT NOT NULL,
            key TEXT NOT NULL, value TEXT NOT NULL,
            PRIMARY KEY (tenant, user, key))""")
        self.conn.commit()

    def put(self, identity, key, value):
        tenant, user = scope(identity)
        with self.conn:
            self.conn.execute(
                "INSERT OR REPLACE INTO memory VALUES (?, ?, ?, ?)",
                (tenant, user, key, value))

    def read(self, identity, key):
        tenant, user = scope(identity)
        row = self.conn.execute(
            "SELECT value FROM memory WHERE tenant=? AND user=? AND key=?",
            (tenant, user, key)).fetchone()
        return row[0] if row else None

    def delete(self, identity, key):
        tenant, user = scope(identity)
        with self.conn:
            self.conn.execute(
                "DELETE FROM memory WHERE tenant=? AND user=? AND key=?",
                (tenant, user, key))

    def unsafe_read(self, user, key):
        # Deliberately broken: user IDs can repeat across tenants.
        return [row[0] for row in self.conn.execute(
            "SELECT value FROM memory WHERE user=? AND key=? ORDER BY tenant",
            (user, key))]

    def close(self):
        self.conn.close()


class Input(TypedDict):
    key: str
    claimed_tenant: str


class State(Input, total=False):
    memory: str | None


def make_graph(db):
    def recall(state: State, runtime: Runtime[Identity]):
        # Ignore user/model-provided claimed_tenant.
        return {"memory": db.read(runtime.context, state["key"])}

    builder = StateGraph(State, context_schema=Identity)
    builder.add_node("recall", recall)
    builder.add_edge(START, "recall")
    builder.add_edge("recall", END)
    return builder.compile()


def main():
    with tempfile.TemporaryDirectory() as directory:
        path = Path(directory) / "memory.sqlite"
        a, b = Identity("team-A", "u-7"), Identity("team-B", "u-7")
        other = Identity("team-A", "u-8")
        db = Memory(path)
        db.put(a, "style", "A: concise")
        db.put(b, "style", "B: detailed")
        db.put(other, "style", "A-other: table")
        unsafe = db.unsafe_read("u-7", "style")
        graph = make_graph(db)
        request = {"key": "style", "claimed_tenant": "team-B"}
        got_a = graph.invoke(request, context=a)["memory"]
        got_b = graph.invoke(request, context=b)["memory"]
        assert unsafe == ["A: concise", "B: detailed"]
        assert got_a == "A: concise" and got_b == "B: detailed"
        assert db.read(other, "style") == "A-other: table"
        assert db.read(Identity("team-A", "missing"), "style") is None
        assert db.read(a, "style' OR 1=1 --") is None
        try:
            db.read(None, "style")
        except PermissionError:
            missing_context_denied = True
        else:
            raise AssertionError("missing context must fail")
        db.put(b, "style", "B: updated")
        assert db.read(a, "style") == "A: concise"
        db.delete(b, "style")
        assert db.read(b, "style") is None
        assert db.read(a, "style") == "A: concise"
        db.close()
        reopened = Memory(path)
        persisted = reopened.read(a, "style")
        assert persisted == "A: concise"
        reopened.close()
        print(json.dumps({
            "unsafe_user_only": unsafe,
            "trusted_A_claims_B": got_a,
            "trusted_B_same_request": got_b,
            "missing_identity_denied": missing_context_denied,
            "B_delete_leaves_A": persisted,
            "reopened_connection": persisted,
            "model_calls": 0,
        }, ensure_ascii=False, indent=2))


if __name__ == "__main__":
    main()
安装和执行
在独立虚拟环境中执行,避免改动已有项目依赖:
python -m venv .venv
# Linux / macOS
source .venv/bin/activate
# Windows PowerShell 改用 .venv\Scripts\Activate.ps1
python -m pip install "langgraph==1.2.17"
python demo.py
本次本地实际使用 langgraph 1.2.17、Python 3.10.21、SQLite 3.53.1;代码使用 Python 3.10 及以上语法。
文章固定的是已验证版本,不表示推荐它作为所有新项目的最新依赖。
真实运行输出
{
  "unsafe_user_only": [
    "A: concise",
    "B: detailed"
  ],
  "trusted_A_claims_B": "A: concise",
  "trusted_B_same_request": "B: detailed",
  "missing_identity_denied": true,
  "B_delete_leaves_A": "A: concise",
  "reopened_connection": "A: concise",
  "model_calls": 0
}
逐项解释:
| 字段 | 观察到什么 | 证明范围 |
|---|---|---|
| unsafe_user_only | 同时返回 A 与 B 的偏好 | 漏 tenant 条件会混入其他租户 |
| trusted_A_claims_B | 返回 A: concise | 本图忽略输入中声称的 B 租户 |
| trusted_B_same_request | 返回 B: detailed | 相同请求在 B 身份下选择 B 的作用域 |
| missing_identity_denied | true | 缺失身份时数据访问层拒绝读取 |
| B_delete_leaves_A | A: concise | 删除 B 同名键没有删除 A 的记录 |
| reopened_connection | A: concise | 关闭并重开连接后,A 的记录仍存在 |
注意最后一项是同一进程内重开数据库连接,没有测试进程崩溃、并发写入或跨机器恢复。
脚本使用临时目录,程序结束后数据库会删除;这让每次复现从干净状态开始。
希望保留实验文件,可以把路径改成专用测试目录,但不要直接指向业务数据库。
06|代码中真正重要的是这四处
1. 复合主键:决定哪些更新算“同一条记忆”
PRIMARY KEY (tenant, user, key) 让团队 A 的 u-7 与团队 B 的 u-7 成为不同记录。
INSERT OR REPLACE 更新 B 的 style,不会覆盖 A 的同名键;本例对此执行了断言。
如果主键只有 (user, key),即使读取过滤写对了,写入时也可能提前把别人的数据覆盖。
不过 OR REPLACE 是简化写法,不解决并发冲突或历史版本保留。
生产写入通常还需要版本号、更新时间和条件更新,防止旧任务晚到一步覆盖较新的记忆。
2. 参数化查询:防注入和隔离条件都要有
? 占位符使 key 中的引号等内容作为参数值处理。
本例额外读取 style' OR 1=1 --,结果为 None,没有扩大查询范围。
但故障版本 unsafe_read() 也用了占位符,仍然混入其他租户。
这说明防 SQL 注入与业务授权是两层不同检查:语句可以完全不受注入影响,却依然合法地查了不该查的数据。
3. 读、写、删使用同一套作用域规则
很多项目只修复读取过滤,写入工具仍接收模型自由填写的 tenant,或者删除接口只按 key 操作。
因此本例让 put()、read() 与 delete() 都从同一个 Identity 派生 tenant 与 user。
测试还验证了同租户另一用户、未知用户、B 的更新与删除不影响 A 等边界。
这不是“安全性已经完全证明”,而是给每条访问路径建立可检查的基本契约。
4. 不能让图节点绕过数据访问层
本例 Memory 对象仍然持有数据库连接,同进程代码可以绕过方法直接查询,这是教学代码的明确限制。
若 Agent 能执行任意代码并接触同一数据库文件,它就可能绕过全部应用过滤。
生产应把数据访问放到受控服务边界,使用权限收敛的数据库账号,必要时采用服务端行级策略,并隔离代码执行环境。
类封装、dataclass 与命名空间都不等于运行时安全边界。
07|换成向量记忆后,不能只在最后过滤结果
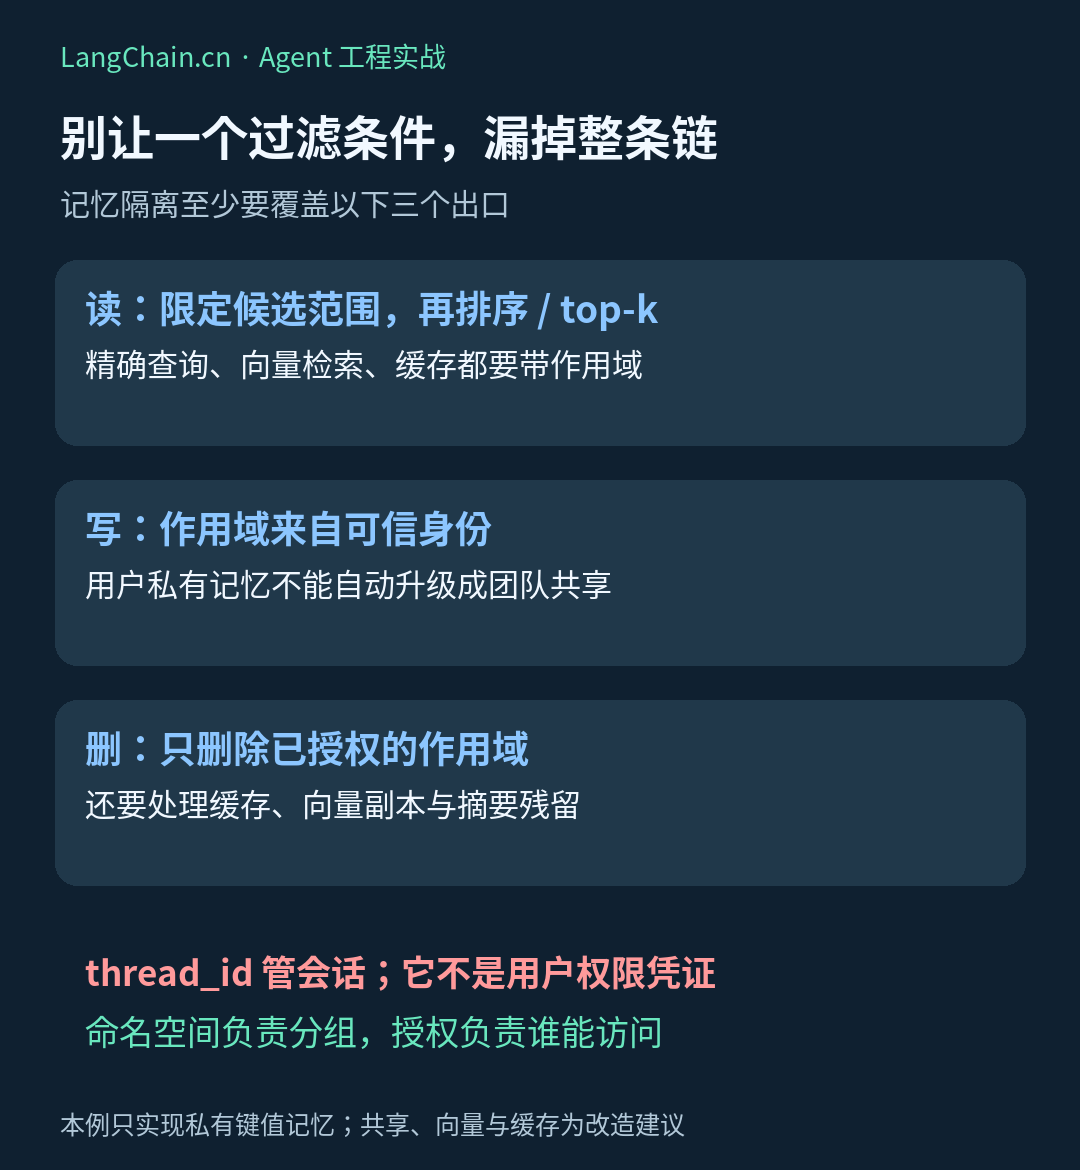
图 2:记忆的隔离需要贯穿完整生命周期,不能只改最后一段 Prompt。
键值示例比较容易看清问题,向量检索更容易藏住它。
假设你先在全库取 top-5,再过滤当前租户,五条候选可能全来自别的客户,过滤后就成了空结果。
此时既可能发生隐藏内容进入日志或中间上下文,也会造成召回异常,看上去像“记忆不稳定”。
对于严格私有检索,应在数据访问和检索候选阶段限定可访问范围,再在该范围内做排序与 top-k。
要检查具体向量数据库和 SDK 的过滤执行语义,不能假设一个名为 filter 的参数一定在所有候选计算之前执行。
还有三个容易漏掉的出口
缓存: 缓存键只含 query,不含租户与用户,数据库过滤正确也可能返回上一位用户的结果。
摘要与历史上下文: 原始记忆删除后,缓存、向量副本和历史摘要可能仍保存旧内容;只删 SQLite 一行不能证明“已彻底遗忘”。
共享区写入: 模型推断出“这是通用经验”不等于它有权把私人信息发布到组织共享区。
共享记忆需要单独定义发布权限、审核、来源与撤回机制,不能只换一个 namespace 名称。
这些是生产改造建议,本地脚本没有实现向量库、缓存、共享发布或删除传播。
08|遇到“串记忆”,按这条路径排查
| 现象 | 优先查哪里 | 能区分问题的证据 |
|---|---|---|
| 两家公司相同 user_id 混入 | 查询与存储复合键 | 实际 SQL、绑定参数及记录作用域 |
| 改请求里的 tenant 就变了 | 接口身份构造 | tenant 来自认证结果还是请求体 |
| 换 thread_id 仍有旧信息 | 长期 Store 与缓存 | 当前节点的召回记录与缓存键 |
| 私有记录删了却仍被提及 | 向量副本、摘要、历史状态 | 删除传播与缓存失效记录 |
| 隔离后总是召回为空 | 过滤与 top-k 顺序 | 授权范围内的候选数与检索计划 |
| 没登录反而读到共享内容 | 默认回退分支 | 缺失身份时是否直接拒绝 |
日志中记录作用域标识和追踪 ID 即可,避免把私人记忆全文无差别写进调试日志。
如果你还在处理“重启后记忆消失”,可继续看 LangGraph 持久化实战;如果要把这些边界加入发布检查,可以参考 Agent 评测门禁教程。
09|一个更实用的上线验收问题
不要只问:“它能不能记住我?”
再问一句:同名用户、换租户、换会话、更新和删除以后,它还能不能只记住该记住的内容?
本例的收获不是一个万能记忆组件,而是一条明确的数据链:由服务端确认身份,在受控数据访问层限定作用域,再把经过授权的结果放入模型上下文。
如果正在做多人共用的企业 RAG 或 Agent,可以在 项目需求与技术合作入口说明租户数量、身份来源、数据范围和验收要求;不要公开业务数据或凭据。
欢迎在本帖补充脱敏的存储结构与检索路径,讨论你的问题出在“存不住”,还是“分不清人”。
复现与来源边界
- 来源核对日期为 2026-10-29;热点来源是 LangChain 10 月 24 日、27 日官方文章,本文未借用厂商流量、成本或转化数据为社区案例背书。
- 实际执行了 LangGraph 图、Runtime context 传递和 SQLite 读写及断言,未调用大模型或付费服务,也未测试真实登录系统与生产数据库权限。
- 三张图和代码为社区原创教学实现,使用 AI 辅助编写、制图及校验;不代表官方完整产品实现。