Agent 回复“已完成”,并不代表目标已经完成。
发布流程里,API 可能已更新,但回滚方案还没验证;负责人可能已经指定,验收证据却没有落盘;所有步骤最终都跑完了,却超过了允许的时间窗口。
如果停止条件只看 Agent 的最后一句话,系统就会把声明误当成事实。
LangChain 最近连续讨论了从任务走向目标的工程变化:Goal Engineering: How to Design Goals发表于 2026 年 11 月 14 日,From tasks to goals发表于 11 月 16 日。
本文不复述文章观点,而是把其中最容易落地的一步做成可运行实验:用目标契约描述必需条件、证据、截止步数和阻塞状态,再比较“只看回复”和“检查状态”的结果。
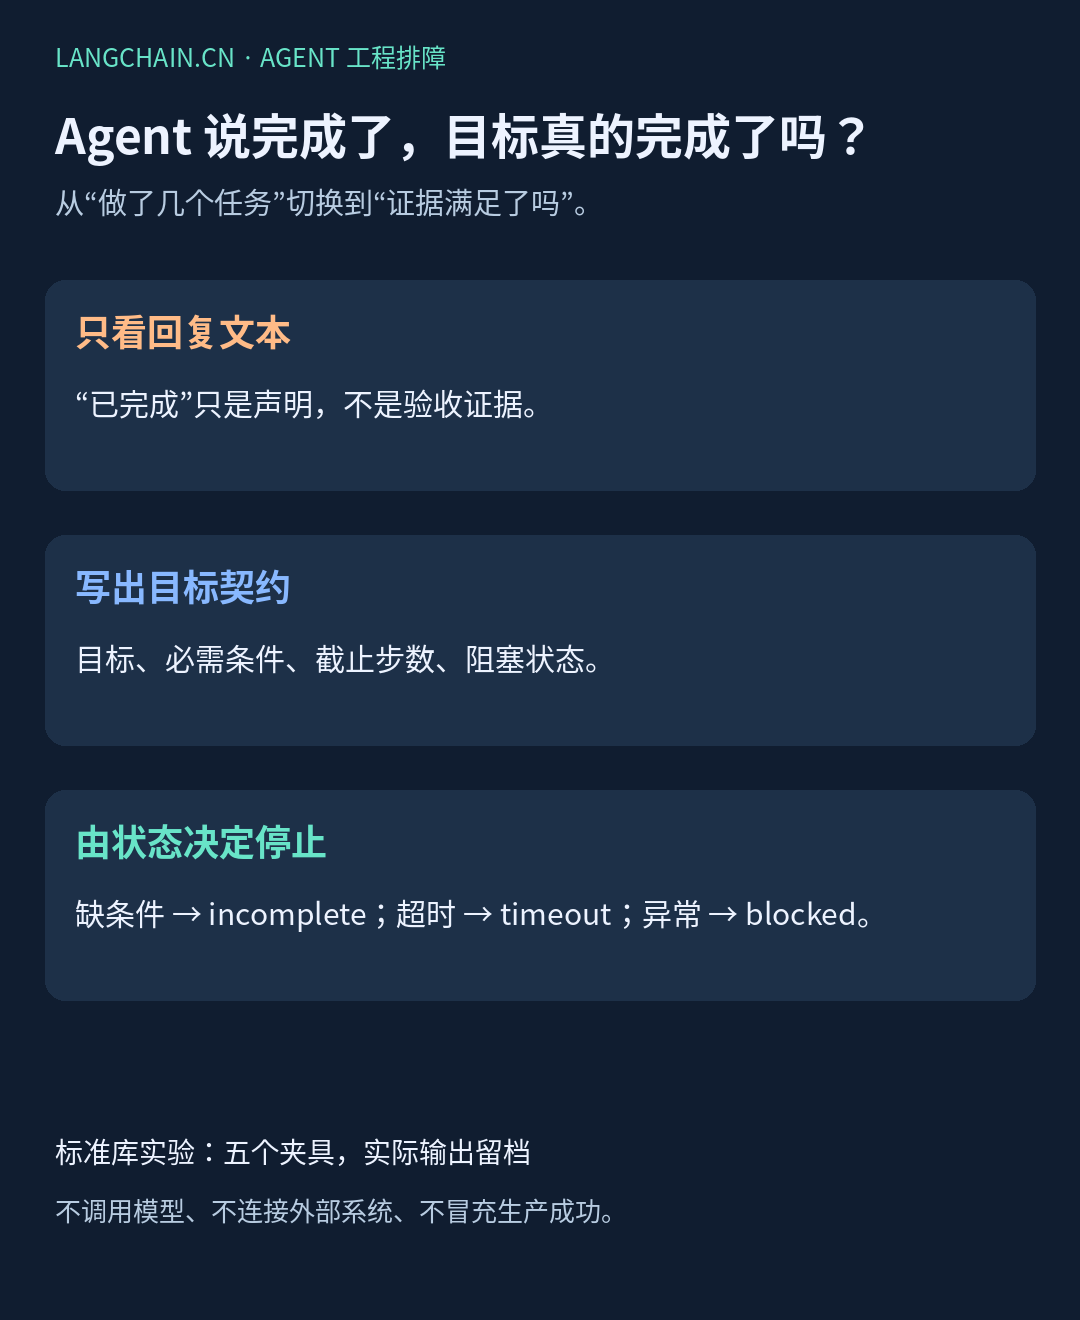
图 1:目标驱动 Agent 的核心变化,是让停止由可核对状态决定,而不是由一句“完成”触发。
环境:Python 3.12.3,标准库,无模型、无 LangChain 云服务、无外部 API。
五组数据是确定性教学夹具,代码和输出均为本地实际执行结果,不代表生产 Agent 成功率。
需要先划清边界:官方讨论的长期目标包含持续责任、触发机制和人类反馈,不是一次 done 就永久结束。
本文只实现长期目标下一个有边界执行周期的验收器;“维护技术文档”这个长期责任仍然存在,release-docs 本轮通过不代表未来不再巡检。
这是受官方动态启发的原创教学实现,不是 LangChain 提供的 Goal API 或官方算法。
一、任务清单和目标契约不是一回事
任务清单回答“接下来做哪些动作”,目标契约回答“什么条件满足时才算完成”。
假设你要发布一份技术文档,目标不是“生成三段文字”,而是:
| 层次 | 示例 | 失败时怎么办 |
|---|---|---|
| 目标 | release-docs |
保持未完成状态 |
| 必需条件 | API 章节、回滚说明、负责人 | 缺一项就不能完成 |
| 证据 | 每项都有 verified 记录 |
没证据不能只靠声明 |
| 截止条件 | 第 4 步前完成 | 超过后进入 timeout |
| 阻塞原因 | 权限不足、外部依赖失败 | 标记 blocked,转补救或人工 |
这套契约不规定 Agent 必须怎样思考,也不保证每个动作都有真实外部副作用。
它只规定系统最后如何判断,以及判断后能否安全停止。
二、状态应该怎样流转?
把 Agent 的自然语言声明、已完成动作、证据和时间步分成四个字段,停止逻辑就能变得可审计。
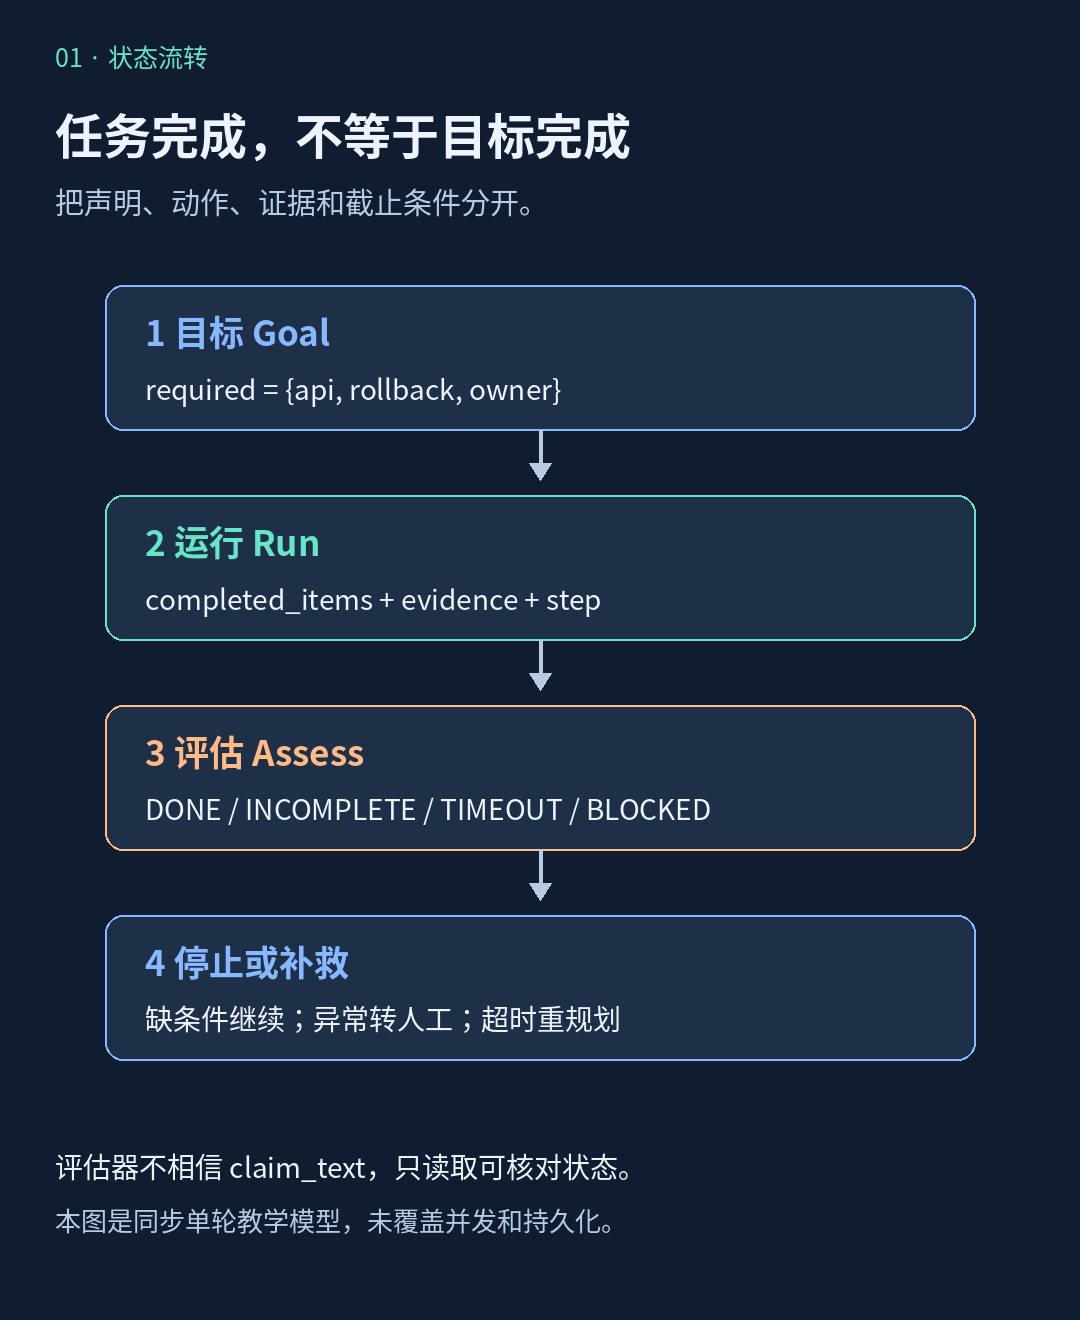
图 2:目标先定义验收条件,运行过程记录动作与证据,评估器再决定完成、未完成、超时或阻塞。
代码里的 claim_text 仍然保留,但评估器故意不使用它。
这不是说自然语言没用,而是它更适合解释过程,不能独自承担业务完成信号。
真实系统还需要记录执行者、来源、时间戳、外部系统回执和幂等键。
本文用字典里的 verified 缩小问题范围,方便读者先复现判断边界。
代码不会证明文档真的存在,也不会验证字符串的来源;若 Agent 可自行写这个字典,仍然能够伪造完成,因此它不是安全边界。
三、完整代码:用标准库先把停止条件钉死
保存为 demo.py,执行:
python3 demo.py
"""Goal-contract demo: deterministic fixtures, no model or external API calls."""
import json
from dataclasses import dataclass
from enum import Enum

class Status(str, Enum):
    DONE = 'done'
    BLOCKED = 'blocked'
    TIMEOUT = 'timeout'
    INCOMPLETE = 'incomplete'

@dataclass(frozen=True)
class Goal:
    goal_id: str
    required: frozenset[str]
    deadline_step: int

@dataclass(frozen=True)
class Run:
    claimed_text: str
    completed_items: frozenset[str]
    evidence: dict[str, str]
    step: int
    error: str | None = None

def assess(goal: Goal, run: Run) -> dict:
    missing = sorted(goal.required - run.completed_items)
    bad_evidence = sorted(k for k in goal.required
                          if run.evidence.get(k) != 'verified')
    if run.error:
        status = Status.BLOCKED
    elif run.step > goal.deadline_step:
        status = Status.TIMEOUT
    elif missing or bad_evidence:
        status = Status.INCOMPLETE
    else:
        status = Status.DONE
    return {'goal_id': goal.goal_id, 'status': status.value,
            'missing': missing, 'unverified': bad_evidence,
            'claim_ignored': run.claimed_text}

def main():
    goal = Goal('release-docs', frozenset({'api', 'rollback', 'owner'}), 4)
    fixtures = {
        'claim_only': Run('已完成发布', frozenset(), {}, 2),
        'partial': Run('已经全部完成', frozenset({'api', 'owner'}),
                       {'api': 'verified', 'owner': 'verified'}, 3),
        'complete': Run('完成', goal.required,
                        {x: 'verified' for x in goal.required}, 3),
        'late': Run('完成', goal.required,
                    {x: 'verified' for x in goal.required}, 5),
        'blocked': Run('无法完成', frozenset({'api'}),
                       {'api': 'verified'}, 2, error='permission_denied'),
    }
    results = {name: assess(goal, run) for name, run in fixtures.items()}
    assert results['claim_only']['status'] == 'incomplete'
    assert results['partial']['missing'] == ['rollback']
    assert results['complete']['status'] == 'done'
    assert results['late']['status'] == 'timeout'
    assert results['blocked']['status'] == 'blocked'
    print(json.dumps({'goal': goal.__dict__ | {'required': sorted(goal.required)},
                      'results': results}, ensure_ascii=False, indent=2))

if __name__ == '__main__':
    main()
Goal 只保存契约,Run 保存单次运行观察到的状态,assess() 负责做纯判断。
把这三件事拆开有两个好处:可以单独测试评估器,也不会因为 Agent 换了提示词就悄悄改变“完成”的定义。
判断顺序也有意固定:先看明确错误,再看是否超时,最后看缺失条件和证据。
生产环境应根据风险定义更细的状态机,例如将外部系统未知结果和永久拒绝分开。
四、实际输出:同一句“完成”,可能是三种结论
{
  "goal": {
    "goal_id": "release-docs",
    "required": [
      "api",
      "owner",
      "rollback"
    ],
    "deadline_step": 4
  },
  "results": {
    "claim_only": {
      "goal_id": "release-docs",
      "status": "incomplete",
      "missing": [
        "api",
        "owner",
        "rollback"
      ],
      "unverified": [
        "api",
        "owner",
        "rollback"
      ],
      "claim_ignored": "已完成发布"
    },
    "partial": {
      "goal_id": "release-docs",
      "status": "incomplete",
      "missing": [
        "rollback"
      ],
      "unverified": [
        "rollback"
      ],
      "claim_ignored": "已经全部完成"
    },
    "complete": {
      "goal_id": "release-docs",
      "status": "done",
      "missing": [],
      "unverified": [],
      "claim_ignored": "完成"
    },
    "late": {
      "goal_id": "release-docs",
      "status": "timeout",
      "missing": [],
      "unverified": [],
      "claim_ignored": "完成"
    },
    "blocked": {
      "goal_id": "release-docs",
      "status": "blocked",
      "missing": [
        "owner",
        "rollback"
      ],
      "unverified": [
        "owner",
        "rollback"
      ],
      "claim_ignored": "无法完成"
    }
  }
}
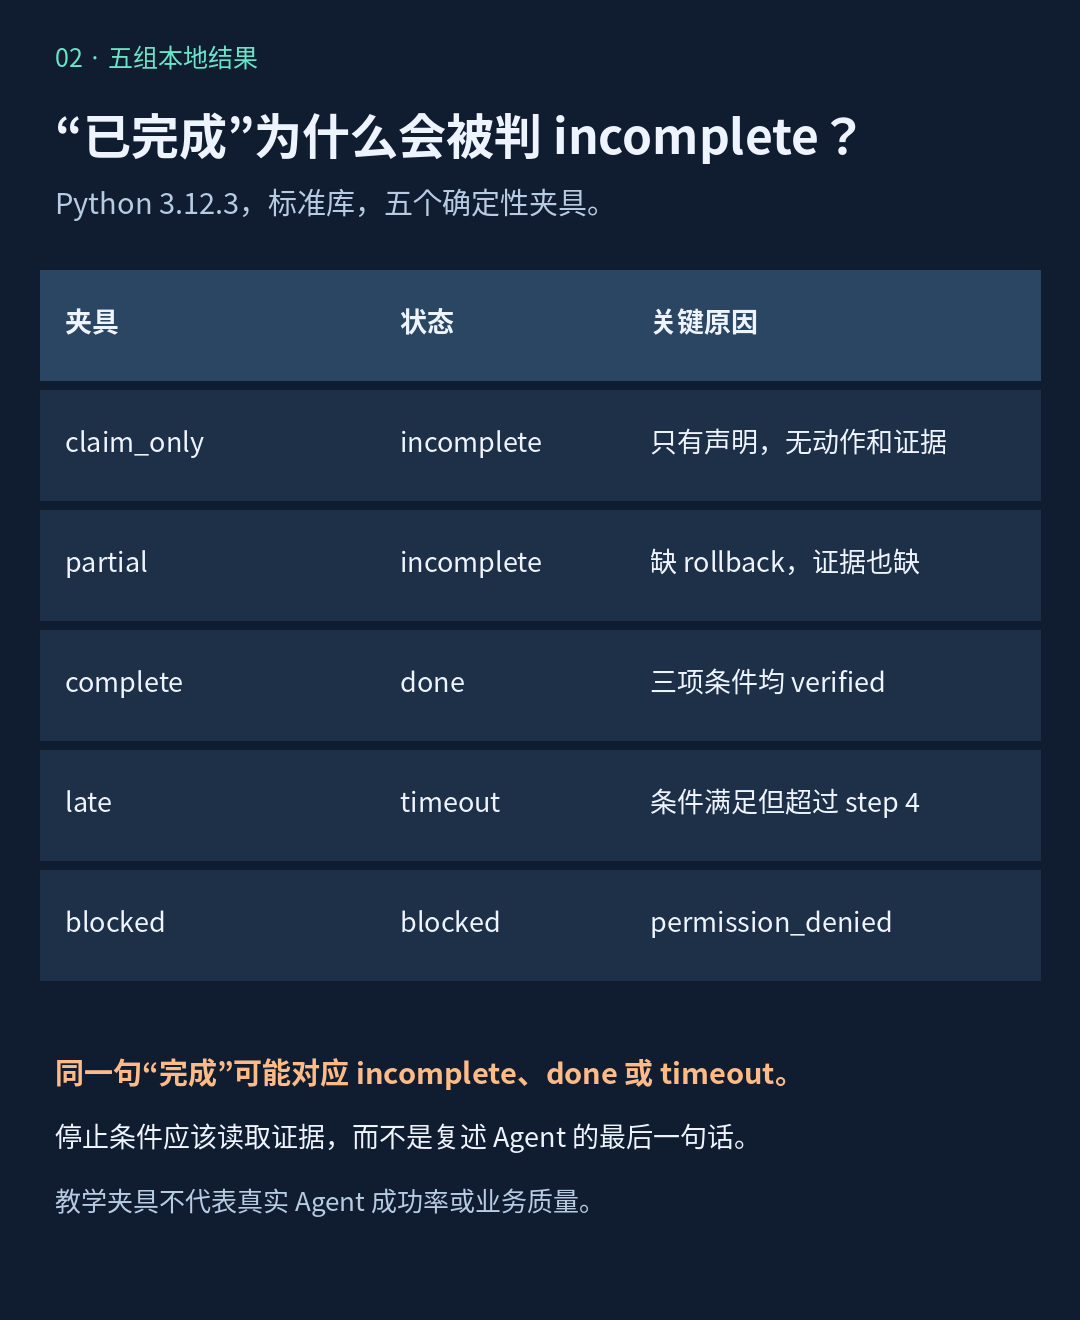
图 3:五组本地夹具显示,声明文本不能替代动作、证据和截止条件。
claim_only:声明不产生证据
运行声称“已完成发布”,但没有完成任何必需项,也没有任何 verified 证据。
结果是 incomplete,三个条件全部列入 missing 和 unverified。
这正是“模型说完成了,但系统不应该停止”的最小复现。
partial:完成两项仍然不能停
API 和负责人已有验证记录,回滚说明缺失。
即使 Agent 回复“已经全部完成”,评估器仍返回 incomplete,并明确指出 rollback。
明确缺什么,比一个 0.67 的总分更有用,因为下一步行动直接可执行。
complete:条件和证据都满足才是 done
三项必需条件全部存在,证据全部为 verified,且运行步数没有超过 4。
这时才返回 done。
done 说明契约被满足,不等于所有外部业务都永久成功。
例如发布后仍可能需要监控、回滚演练或人工抽样。
late:满足条件也可能来不及
这组数据和 complete 拥有相同的条件与证据,但 step=5 超过截止步数,因此返回 timeout。
是否允许“迟到完成”取决于产品规则,不能在看到结果后临时改阈值。
对实时任务、审批和窗口期活动,超时本身就是业务结果。
本例的 step 是离散预算计数,不是墙钟时间;step=4 仍允许完成,只有大于 4 才超出预算。
这里 timeout 是教学状态名,生产中应区分步数预算耗尽与实际时间超时。
blocked:异常不是 incomplete 的同义词
遇到 permission_denied 时返回 blocked,并保留仍未满足的条件。
这让系统可以区分“继续补任务”和“当前无法继续”,避免 Agent 在权限问题上无限重试。
五、从示例走到真实 Agent,还需要补什么?
1. 证据来源必须可追踪
不要让模型自己写 verified=true 就算完成。
证据应来自工具回执、数据库状态、测试结果、人工确认或外部系统查询,并带来源、时间和关联 ID。
如果外部系统超时,状态应该是 unknown 或 blocked,而不是因为模型“感觉已经提交”就变成 done。
这和此前恢复后重复执行与业务幂等教程中的未知结果边界是一致的。
2. 目标契约和执行权限要分开
Goal 只描述验收条件,不代表 Agent 获得了完成这些动作的权限。
发布、删除、转账、发送通知等副作用仍需独立的授权、审批和幂等设计。
把“目标已满足”当成“可以继续做所有动作”,会让验收逻辑反过来扩大权限。
3. 目标变化要有版本
用户在运行中改变范围时,应该创建新版本或记录变更,而不是覆盖原始目标。
否则事后无法判断 Agent 是完成了旧目标、部分完成新目标,还是评估标准被改写了。
建议保存 goal_id、goal_version、输入来源和变更时间,配合逐条回归检查。
4. 超时后的重规划必须留下原因
超时后可以缩小范围、延长截止时间或转人工,但每次调整都应保留谁做的、为什么做、影响哪些条件。
不要让 Agent 通过反复改 deadline 把一次失败伪装成成功。
六、如何接入 LangGraph 或 LangChain Agent?
可以把目标契约放在运行上下文或持久化状态中,把每个关键节点的结构化结果写入 evidence,在终止节点统一调用评估器。
对于有工具调用的 Agent,每个工具返回值都应带业务含义,而不是只把自然语言结果拼回上下文。
例如“已发送”应该对应邮件服务回执和消息 ID,“已发布”应该对应目标系统的对象 ID 与可访问状态。
对于多步骤工作流,节点可以返回 progress 和 evidence_delta,而不是直接返回 done=true。
最终状态由评估器聚合,避免某个中间节点提前结束全局运行。
这类设计与逐条评测和回归排障可以组合:评测检查不同目标和失败边界,目标契约检查一次运行的终止状态。
本文没有调用 LangGraph SDK,也没有测试并发、持久化恢复或真实外部回执。
七、上线前的最小验收清单
- 每个目标都有稳定 ID、版本和明确必需条件。
- 每个必需条件都有可追踪证据来源,模型声明不单独算证据。
- 缺条件、异常、未知结果和超时有不同状态。
- 停止前检查业务状态,不能只看最后一条 AI 回复。
- 目标变更、重规划和人工接管都有审计记录。
- 用完整、部分、迟到、权限拒绝和外部超时夹具做回归。
官方来源与验证范围
- Goal Engineering: How to Design Goals,LangChain,2026-11-14。
- From tasks to goals,LangChain,2026-11-16。
- LangChain 1.5.0 发布记录,用于上下文工程版本背景,不把新功能与本文目标契约混为一谈。
本地实验于 2026-11-17 用 Python 3.12.3 执行,五组断言通过;不调用模型、不连接 LangChain 云服务、不测试生产业务或真实目标成功率。
如果你的 Agent 也经常在“说完成”后留下半成品,先把完成条件从提示词里移到结构化状态,再决定是否允许停止。